

120
4 M´ ethodes it´ eratives pour la r´ esolution des syst` emes lin´ eaires
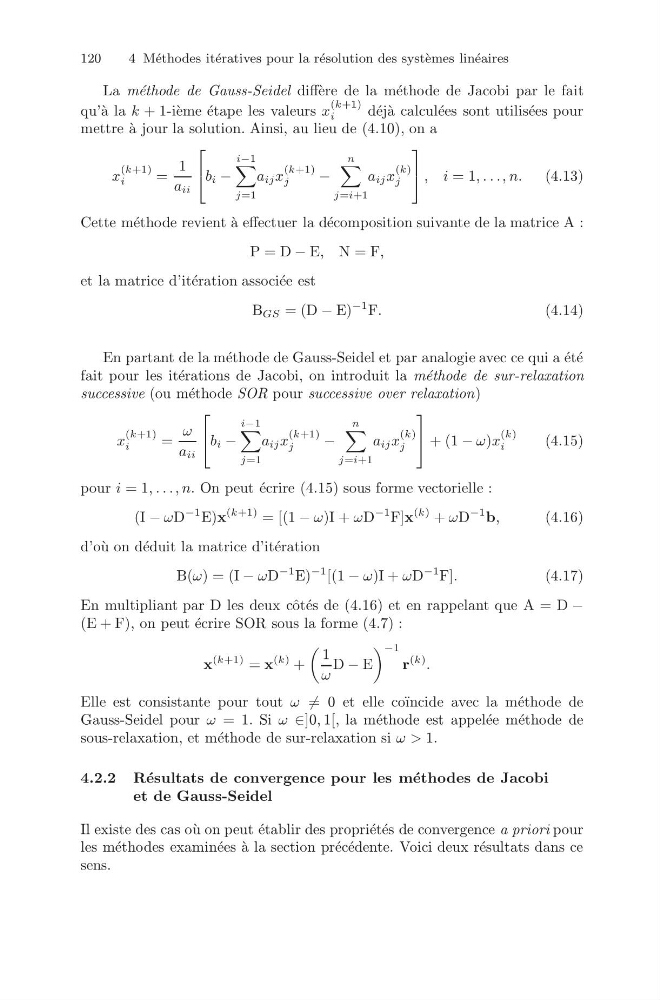
La m´ ethode de Gauss-Seidel diff` ere de la m´ ethode de Jacobi par le fait
qu’` a la k + 1-i` eme ´ etape les valeurs x
(k+1)
i
d´ ej` a calcul´ ees sont utilis´ ees pour
mettre ` a jour la solution. Ainsi, au lieu de (4.10), on a
x
(k+1)
i
=
1
a ii
⎡
⎣ b i −
i−1
j=1
a ij x
(k+1)
j
−
n
j=i+1
a ij x
(k)
j
⎤
⎦ , i = 1, . . ., n.
(4.13)
Cette m´ ethode revient `
a effectuer la d´ ecomposition suivante de la matrice A :
P = D − E, N = F,
et la matrice d’it´ eration associ´ ee est
B GS = (D − E)
−1 F.
(4.14)
En partant de la m´ ethode de Gauss-Seidel et par analogie avec ce qui a ´ et´ e
fait pour les it´ erations de Jacobi, on introduit la m´ ethode de sur-relaxation
successive (ou m´ ethode SOR pour successive over relaxation)
x
(k+1)
i
=
ω
a ii
⎡
⎣ b i −
i−1
j=1
a ij x
(k+1)
j
−
n
j=i+1
a ij x
(k)
j
⎤
⎦ + (1 − ω)x
(k)
i
(4.15)
pour i = 1, . . ., n. On peut ´ ecrire (4.15) sous forme vectorielle :
(I − ωD
−1 E)x
(k+1) = [(1 − ω)I + ωD
−1 F]x
(k) + ωD
−1 b,
(4.16)
d’o` u on d´ eduit la matrice d’it´ eration
B(ω) = (I − ωD
−1 E)
−1 [(1 − ω)I + ωD
−1 F].
(4.17)
En multipliant par D les deux cˆ ot´ es de (4.16) et en rappelant que A = D −
(E + F), on peut ´ ecrire SOR sous la forme (4.7) :
x
(k+1) = x
(k) +
1
ω
D − E
−1
r
(k) .
Elle est consistante pour tout ω = 0 et elle co¨ ıncide avec la m´ ethode de
Gauss-Seidel pour ω = 1. Si ω ∈]0, 1[, la m´ ethode est appel´ ee m´ ethode de
sous-relaxation, et m´ ethode de sur-relaxation si ω > 1.
4.2.2 R´ esultats de convergence pour les m´ ethodes de Jacobi
et de Gauss-Seidel
Il existe des cas o` u on peut ´ etablir des propri´ et´ es de convergence a priori pour
les m´ ethodes examin´ ees ` a la section pr´ ec´ edente. Voici deux r´ esultats dans ce
sens.