

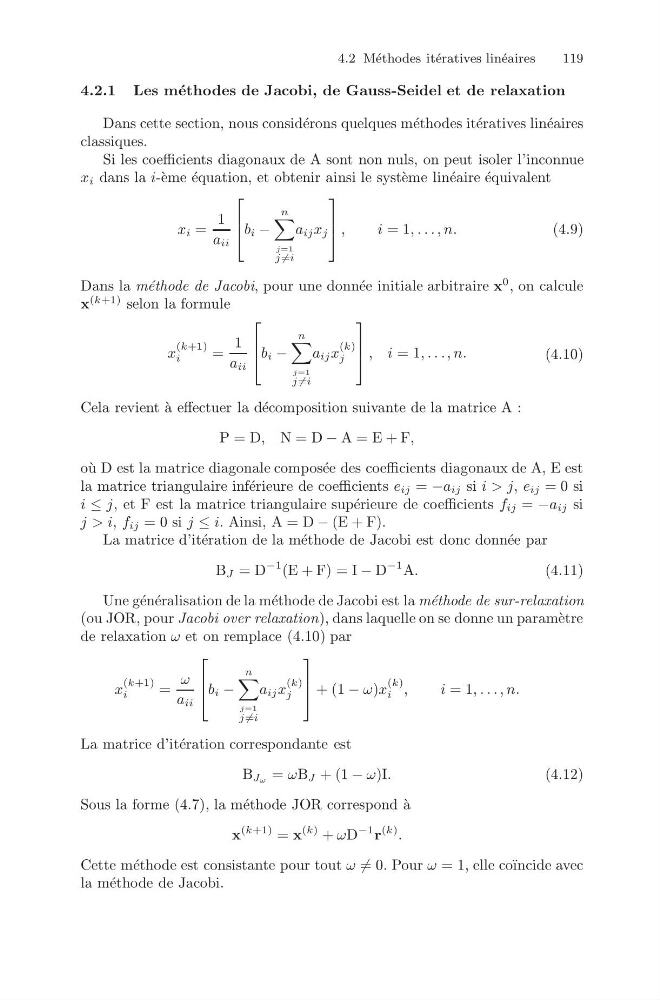
4.2 M´ ethodes it´ eratives lin´ eaires
119
4.2.1 Les m´ ethodes de Jacobi, de Gauss-Seidel et de relaxation
Dans cette section, nous consid´ erons quelques m´ ethodes it´ eratives lin´ eaires
classiques.
Si les coefficients diagonaux de A sont non nuls, on peut isoler l’inconnue
x i dans la i-` eme ´ equation, et obtenir ainsi le syst` eme lin´ eaire ´ equivalent
x i =
1
a ii
⎡
⎢
⎣bi −
n
j=1
j =i
a ij x j
⎤
⎥
⎦ ,
i= 1, . . . , n.
(4.9)
Dans la m´ ethode de Jacobi, pour une donn´ ee initiale arbitraire x
0 , on calcule
x
(k+1) selon la formule
x
(k+1)
i
=
1
a ii
⎡
⎢
⎣bi −
n
j=1
j =i
a ij x
(k)
j
⎤
⎥
⎦ , i = 1, . . ., n.
(4.10)
Cela revient `
a effectuer la d´ ecomposition suivante de la matrice A :
P = D, N = D − A = E + F,
o` u D est la matrice diagonale compos´ ee des coefficients diagonaux de A, E est
la matrice triangulaire inf´ erieure de coefficients e ij = −a ij si i > j, e ij = 0 si
i ≤ j, et F est la matrice triangulaire sup´ erieure de coefficients f ij = −a ij si
j > i, f ij = 0 si j ≤ i. Ainsi, A = D − (E + F).
La matrice d’it´ eration de la m´ ethode de Jacobi est donc donn´ ee par
B J = D
−1 (E + F) = I − D
−1 A.
(4.11)
Une g´ en´ eralisation de la m´ ethode de Jacobi est la m´ ethode de sur-relaxation
(ou JOR, pour Jacobi over relaxation), dans laquelle on se donne un param` etre
de relaxation ω et on remplace (4.10) par
x
(k+1)
i
=
ω
a ii
⎡
⎢
⎣bi −
n
j=1
j =i
a ij x
(k)
j
⎤
⎥
⎦ + (1 − ω)x
(k)
i ,
i= 1, . . . , n.
La matrice d’it´ eration correspondante est
B Jω = ωB J + (1 − ω)I.
(4.12)
Sous la forme (4.7), la m´ ethode JOR correspond `
a
x
(k+1) = x
(k) + ωD
−1 r
(k) .
Cette m´ ethode est consistante pour tout ω = 0. Pour ω = 1, elle co¨ ıncide avec
la m´ ethode de Jacobi.