

112
8 Algorithme EM et mélanges
L c (θ, ˜
θ, X) =
J
j=1
n
i=1
g ˜
θ (j | X = X i )
log α(j)
+
J
j=1
n
i=1
g ˜
θ (j | X = X i )(log λ(j) − λ(j)x i ).
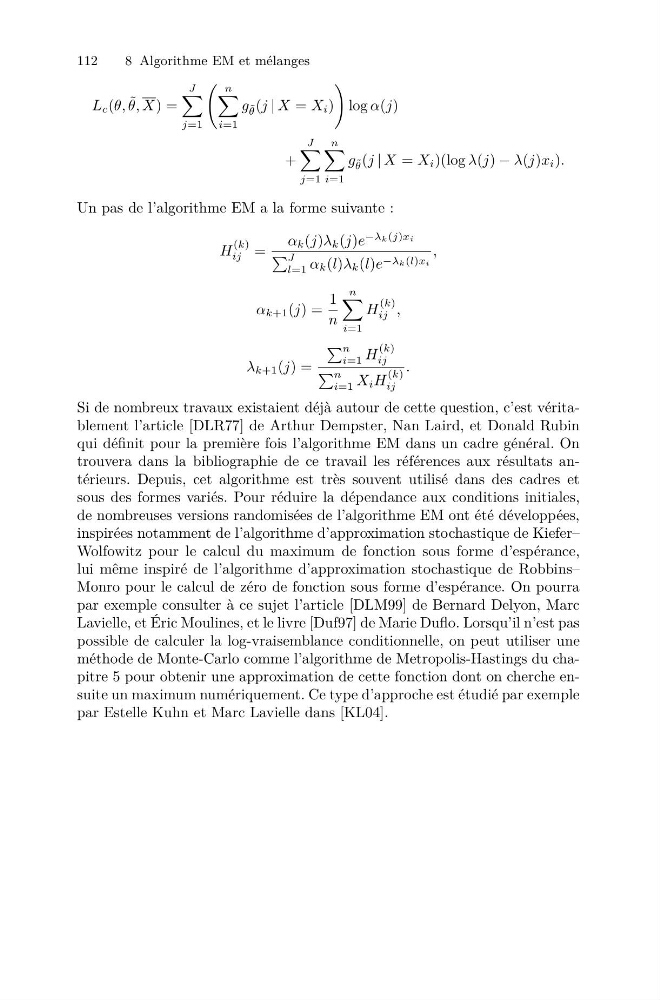
Un pas de l’algorithme EM a la forme suivante :
H
(k)
ij =
α k (j)λ k (j)e
−λ k (j)xi
J
l=1 α k (l)λ k (l)e −λ k (l)xi
,
α k+1 (j) =
1
n
n
i=1
H
(k)
ij ,
λ k+1 (j) =
n
i=1 H
(k)
ij
n
i=1 X i H
(k)
ij
.
Si de nombreux travaux existaient déjà autour de cette question, c’est véritablement l’article [DLR77] de Arthur Dempster, Nan Laird, et Donald Rubin
qui définit pour la première fois l’algorithme EM dans un cadre général. On
trouvera dans la bibliographie de ce travail les références aux résultats antérieurs. Depuis, cet algorithme est très souvent utilisé dans des cadres et
sous des formes variés. Pour réduire la dépendance aux conditions initiales,
de nombreuses versions randomisées de l’algorithme EM ont été développées,
inspirées notamment de l’algorithme d’approximation stochastique de Kiefer–
Wolfowitz pour le calcul du maximum de fonction sous forme d’espérance,
lui même inspiré de l’algorithme d’approximation stochastique de Robbins–
Monro pour le calcul de zéro de fonction sous forme d’espérance. On pourra
par exemple consulter à ce sujet l’article [DLM99] de Bernard Delyon, Marc
Lavielle, et Éric Moulines, et le livre [Duf97] de Marie Duflo. Lorsqu’il n’est pas
possible de calculer la log-vraisemblance conditionnelle, on peut utiliser une
méthode de Monte-Carlo comme l’algorithme de Metropolis-Hastings du chapitre 5 pour obtenir une approximation de cette fonction dont on cherche ensuite un maximum numériquement. Ce type d’approche est étudié par exemple
par Estelle Kuhn et Marc Lavielle dans [KL04].