

94
7 Chaînes de Markov cachées
n est codante (respectivement non codante) alors U n = 1 (respectivement
U n = 0). On modélise la loi de (X, U ) = ((X n , U n )) n0 par une chaîne de
Markov homogène sur A × U de matrice de transition donnée par
P ((x, u), (x
, u
)) = P(X n+1 = x
, U n+1 = u
| X n = x, U n = u)
= ρ(u, u
)π u (x, x
),
où ρ est une matrice de transition sur {0, 1} et où π 0 et π 1 sont des matrice
de transitions sur A. On suppose que tous les coefficients des matrices ρ,
π 0 et π 1 sont strictement positifs. La composante U agit comme une sorte
d’interrupteur ou de commutateur (markovien) à deux positions.
La chaîne (X, U ) est irréductible, récurrente et apériodique car tous les
coefficients de sa matrice de transition sont strictement positifs. En général
la projection X = (X n ) n0 , qui modélise le brin d’ADN, n’est pas une chaîne
de Markov. Le modèle est rigide : la loi de la longueur d’un segment de la
catégorie u ∈ U suit une loi géométrique de paramètre 1 − ρ(u, u).
On se place à présent dans la situation où la matrice de transition de
(X, U ), c’est-à-dire le triplet ρ, π 0 , π 1 , est connue, par exemple grâce à une
estimation menée au préalable (nous y reviendrons plus loin). La question est à
présent la suivante : peut-on déterminer la loi de (U j ) 1jl conditionnellement
aux observations (X i ) 1il ? On dit que la chaîne de Markov (X, U ) est cachée
car la composante U n’est pas observée. Seule la composante X est observée.
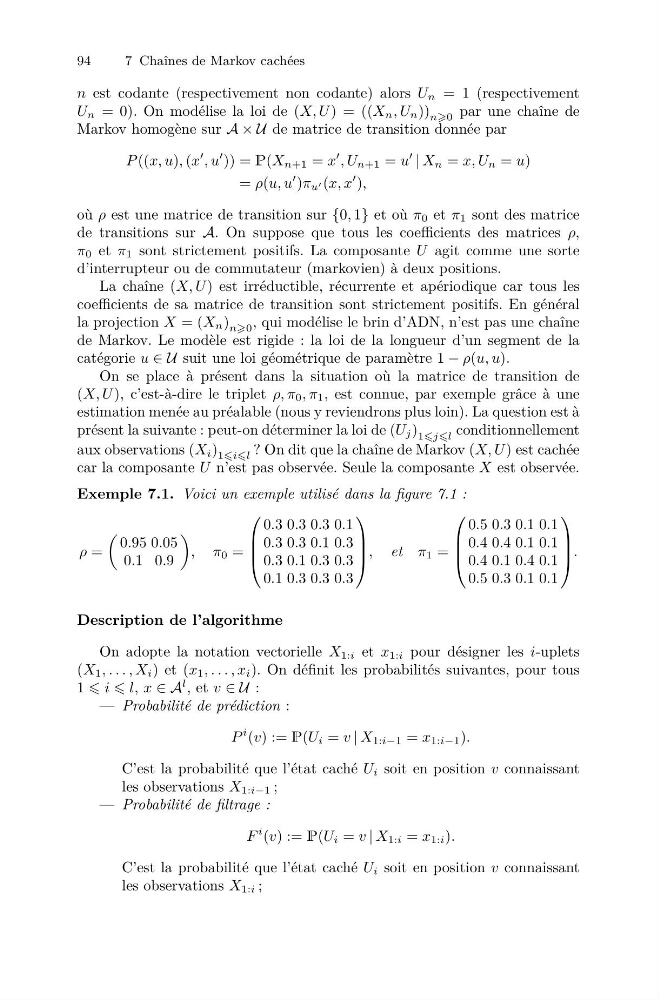
Exemple 7.1. Voici un exemple utilisé dans la figure 7.1 :
ρ =
0.95 0.05
0.1 0.9
, π 0 =
⎛
⎜
⎜
⎝
0.3 0.3 0.3 0.1
0.3 0.3 0.1 0.3
0.3 0.1 0.3 0.3
0.1 0.3 0.3 0.3
⎞
⎟
⎟
⎠ , et π 1 =
⎛
⎜
⎜
⎝
0.5 0.3 0.1 0.1
0.4 0.4 0.1 0.1
0.4 0.1 0.4 0.1
0.5 0.3 0.1 0.1
⎞
⎟
⎟
⎠ .
Description de l’algorithme
On adopte la notation vectorielle X 1:i et x 1:i pour désigner les i-uplets
(X 1 , . . . , X i ) et (x 1 , . . . , x i ). On définit les probabilités suivantes, pour tous
1 i l, x ∈ A
l , et v ∈ U :
— Probabilité de prédiction :
P
i (v) := P(U i = v | X 1:i−1 = x 1:i−1 ).
C’est la probabilité que l’état caché U i soit en position v connaissant
les observations X 1:i−1 ;
— Probabilité de filtrage :
F
i (v) := P(U i = v | X 1:i = x 1:i ).
C’est la probabilité que l’état caché U i soit en position v connaissant
les observations X 1:i ;