

13.5 Algorithme esp´ erance-maximisation
401
les algorithmes de gradient stochastiques d´ ecrits dans la section 13.4, cet algorithme EM cherche ` a maximiser localement les fonctions de vraisemblance
d’un param` etre θ en fonction d’une s´ equence d’observations
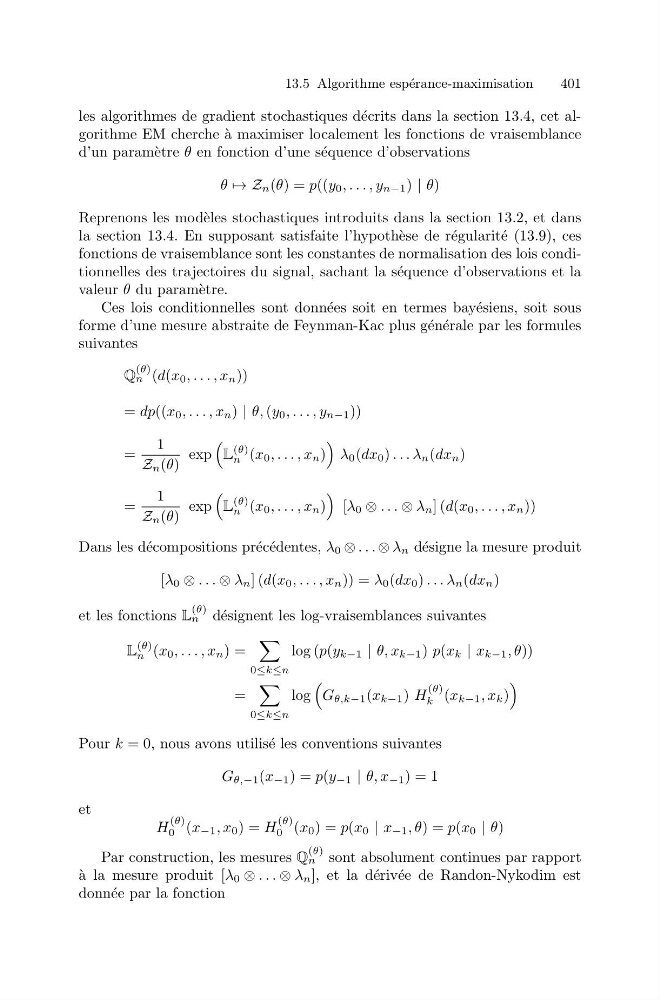
θ → Z n (θ) = p((y 0 , . . . , y n−1 ) | θ)
Reprenons les mod` eles stochastiques introduits dans la section 13.2, et dans
la section 13.4. En supposant satisfaite l’hypoth` ese de r´ egularit´ e (13.9), ces
fonctions de vraisemblance sont les constantes de normalisation des lois conditionnelles des trajectoires du signal, sachant la s´ equence d’observations et la
valeur θ du param` etre.
Ces lois conditionnelles sont donn´ ees soit en termes bay´ esiens, soit sous
forme d’une mesure abstraite de Feynman-Kac plus g´ en´ erale par les formules
suivantes
Q
(θ)
n (d(x 0 , . . . , x n ))
= dp((x 0 , . . . , x n ) | θ, (y 0 , . . . , y n−1 ))
=
1
Z n (θ)
exp
L
(θ)
n (x 0 , . . . , x n )
λ 0 (dx 0 ) . . . λ n (dx n )
=
1
Z n (θ)
exp
L
(θ)
n (x 0 , . . . , x n )
[λ 0 ⊗ . . . ⊗ λ n ] (d(x 0 , . . . , x n ))
Dans les d´ ecompositions pr´ ec´ edentes, λ 0 ⊗ . . . ⊗ λ n d´ esigne la mesure produit
[λ 0 ⊗ . . . ⊗ λ n ] (d(x 0 , . . . , x n )) = λ 0 (dx 0 ) . . . λ n (dx n )
et les fonctions L
(θ)
n d´ esignent les log-vraisemblances suivantes
L
(θ)
n (x 0 , . . . , x n ) =
0≤k≤n
log (p(y k−1 | θ, x k−1 ) p(x k | x k−1 , θ))
=
0≤k≤n
log
G θ,k−1 (x k−1 ) H
(θ)
k (x k−1 , x k )
Pour k = 0, nous avons utilis´ e les conventions suivantes
G θ,−1 (x −1 ) = p(y −1 | θ, x −1 ) = 1
et
H
(θ)
0 (x −1 , x 0 ) = H
(θ)
0 (x 0 ) = p(x 0 | x −1 , θ) = p(x 0 | θ)
Par construction, les mesures Q
(θ)
n sont absolument continues par rapport
` a la mesure produit [λ 0 ⊗ . . . ⊗ λ n ], et la d´ eriv´ ee de Randon-Nykodim est
donn´ ee par la fonction