

400
13 Analyse bay´ esienne
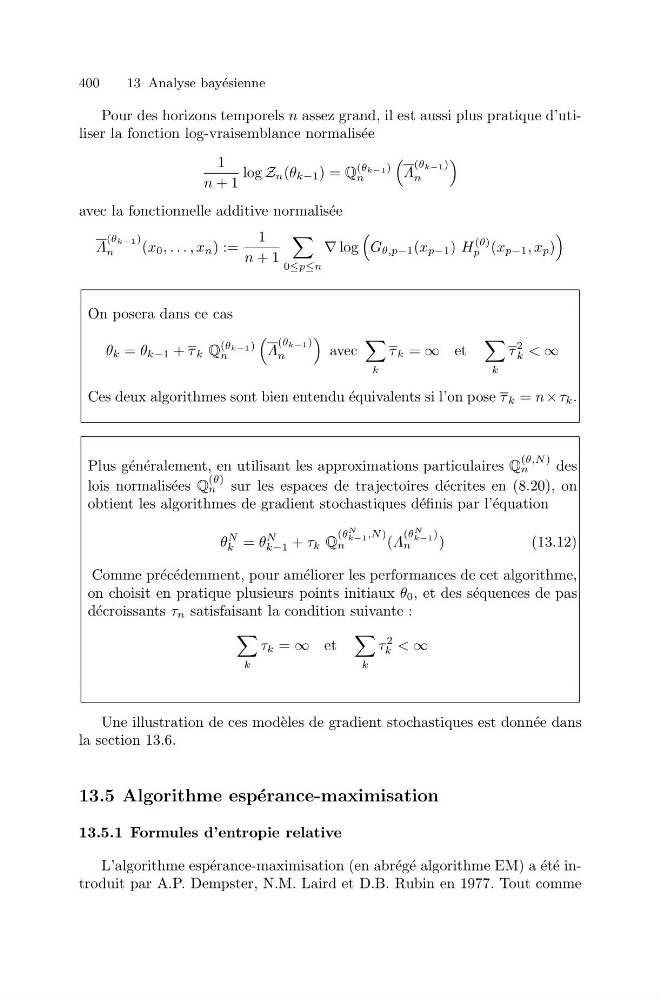
Pour des horizons temporels n assez grand, il est aussi plus pratique d’utiliser la fonction log-vraisemblance normalis´ ee
1
n + 1
log Z n (θ k−1 ) = Q
(θ k−1 )
n
Λ
(θ k−1 )
n
avec la fonctionnelle additive normalis´ ee
Λ
(θ k−1 )
n
(x 0 , . . . , x n ) :=
1
n + 1
0≤p≤n
∇ log
G θ,p−1 (x p−1 ) H
(θ)
p (x p−1 , x p )
On posera dans ce cas
θ k = θ k−1 + τ k Q
(θ k−1 )
n
Λ
(θ k−1 )
n
avec
k
τ k = ∞ et
k
τ
2
k < ∞
Ces deux algorithmes sont bien entendu ´ equivalents si l’on pose τ k = n× τ k .
Plus g´ en´ eralement, en utilisant les approximations particulaires Q
(θ,N )
n
des
lois normalis´ ees Q
(θ)
n sur les espaces de trajectoires d´ ecrites en (8.20), on
obtient les algorithmes de gradient stochastiques d´ efinis par l’´ equation
θ
N
k = θ
N
k−1 + τ k Q
(θ
N
k−1 ,N )
n
(Λ
(θ
N
k−1 )
n
)
(13.12)
Comme pr´ ec´ edemment, pour am´ eliorer les performances de cet algorithme,
on choisit en pratique plusieurs points initiaux θ 0 , et des s´ equences de pas
d´ ecroissants τ n satisfaisant la condition suivante :
k
τ k = ∞ et
k
τ
2
k < ∞
Une illustration de ces mod` eles de gradient stochastiques est donn´ ee dans
la section 13.6.
13.5 Algorithme esp´ erance-maximisation
13.5.1 Formules d’entropie relative
L’algorithme esp´ erance-maximisation (en abr´ eg´ e algorithme EM) a ´ et´ e introduit par A.P. Dempster, N.M. Laird et D.B. Rubin en 1977. Tout comme