

13.4 Algorithme de gradient stochastique
397
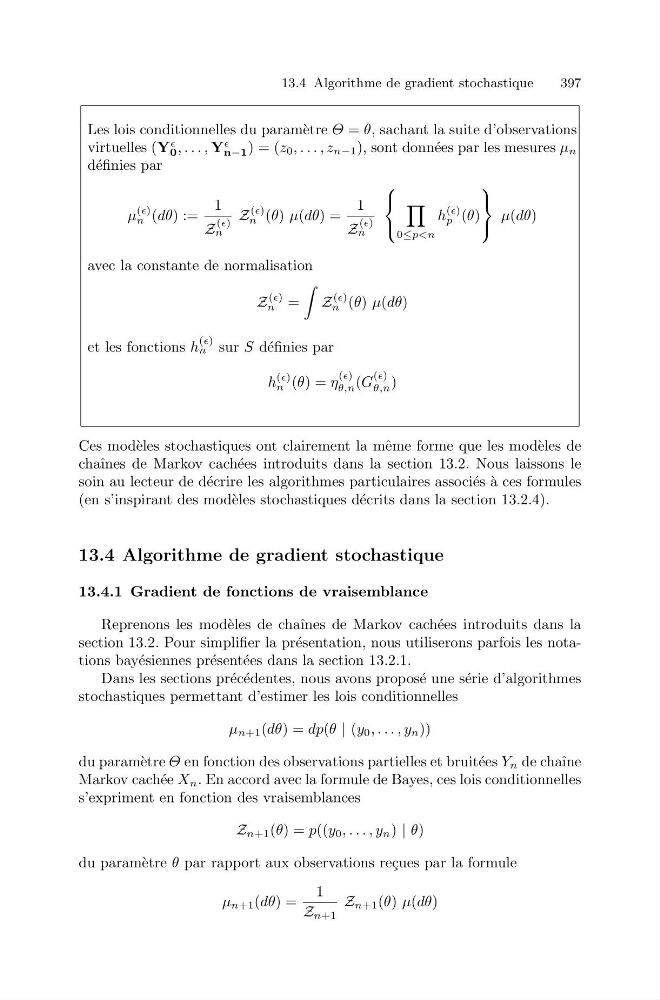
Les lois conditionnelles du param` etre Θ = θ, sachant la suite d’observations
virtuelles (Y
0 , . . . , Y
n−1 ) = (z 0 , . . . , z n−1 ), sont donn´ ees par les mesures μ n
d´ efinies par
μ
()
n (dθ) :=
1
Z
()
n
Z
()
n (θ) μ(dθ) =
1
Z
()
n
⎧
⎨
⎩
0≤p
()
p (θ)
⎫
⎬
⎭
μ(dθ)
avec la constante de normalisation
Z
()
n =
Z
()
n (θ) μ(dθ)
et les fonctions h
()
n sur S d´ efinies par
h
()
n (θ) = η
()
θ,n (G
()
θ,n )
Ces mod` eles stochastiques ont clairement la mˆ eme forme que les mod` eles de
chaˆ ınes de Markov cach´ ees introduits dans la section 13.2. Nous laissons le
soin au lecteur de d´ ecrire les algorithmes particulaires associ´ es ` a ces formules
(en s’inspirant des mod` eles stochastiques d´ ecrits dans la section 13.2.4).
13.4 Algorithme de gradient stochastique
13.4.1 Gradient de fonctions de vraisemblance
Reprenons les mod` eles de chaˆ ınes de Markov cach´ ees introduits dans la
section 13.2. Pour simplifier la pr´ esentation, nous utiliserons parfois les notations bay´ esiennes pr´ esent´ ees dans la section 13.2.1.
Dans les sections pr´ ec´ edentes, nous avons propos´ e une s´ erie d’algorithmes
stochastiques permettant d’estimer les lois conditionnelles
μ n+1 (dθ) = dp(θ | (y 0 , . . . , y n ))
du param` etre Θ en fonction des observations partielles et bruit´ ees Y n de chaˆ ıne
Markov cach´ ee X n . En accord avec la formule de Bayes, ces lois conditionnelles
s’expriment en fonction des vraisemblances
Z n+1 (θ) = p((y 0 , . . . , y n ) | θ)
du param` etre θ par rapport aux observations re¸ cues par la formule
μ n+1 (dθ) =
1
Z n+1
Z n+1 (θ) μ(dθ)