

Informatique biomédicale et recherche en santé – Informatique translationnelle
487
L’identification d’un essai clinique adapté au patient est complexe du fait
de la multiplicité des protocoles disponibles, du nombre et de la complexité
des critères d’inclusion/exclusion et de la surcharge de travail que représente,
pour le médecin, une recherche systématique des protocoles auxquels le patient
pourrait être éligible.
Le projet ASTEC, développé à l’université de Rennes, permet d’automatiser et
de rendre systématique la recherche d’essais cliniques de cancérologie auxquels
les patients sont éligibles.
Dans le projet ASTEC, la représentation syntaxique et sémantique commune
aux critères d’éligibilité d’une part et aux données cliniques des patients qui
permet leur mise en correspondance est basée sur la norme HL7 CDA (Clinical
Document Architecture) et une ontologie de cancérologie (basée sur la National
Cancer Institute Terminology). La figure 7 illustre le processus d’utilisation du
système ASTEC.
18.5.2.3 Projets d’optimisation de la collecte de données pour la recherche
ou la santé publique
La conception et la réalisation des cahiers d’observation (« Case Report
Form », CRF en anglais) sont les étapes les plus critiques dans un essai clinique
et conditionne sa réussite. La qualité des données recueillies repose d’abord et
avant tout sur la qualité de la conception des cahiers d’observation.
Des études ont estimé que 30 à 50 % des items du dossier de soins étaient
pertinents dans un contexte de recherche biomédicale et donc que ces données
étaient saisies de multiples fois : au sein du DPI, du Système de Gestion des
Données de Recherche Clinique (SGDRC) et parfois même disponibles sous
forme papier. Une étude récente rapporte même qu’au niveau des unités de
recherche clinique, les investigateurs estiment que 70-100 % des données sont
dupliquées entre le dossier patient et le cahier d’observation. La saisie multiple
des mêmes données au sein d’applications différentes est une perte de temps au
cours du processus de mise en œuvre d’un essai clinique et également à l’origine
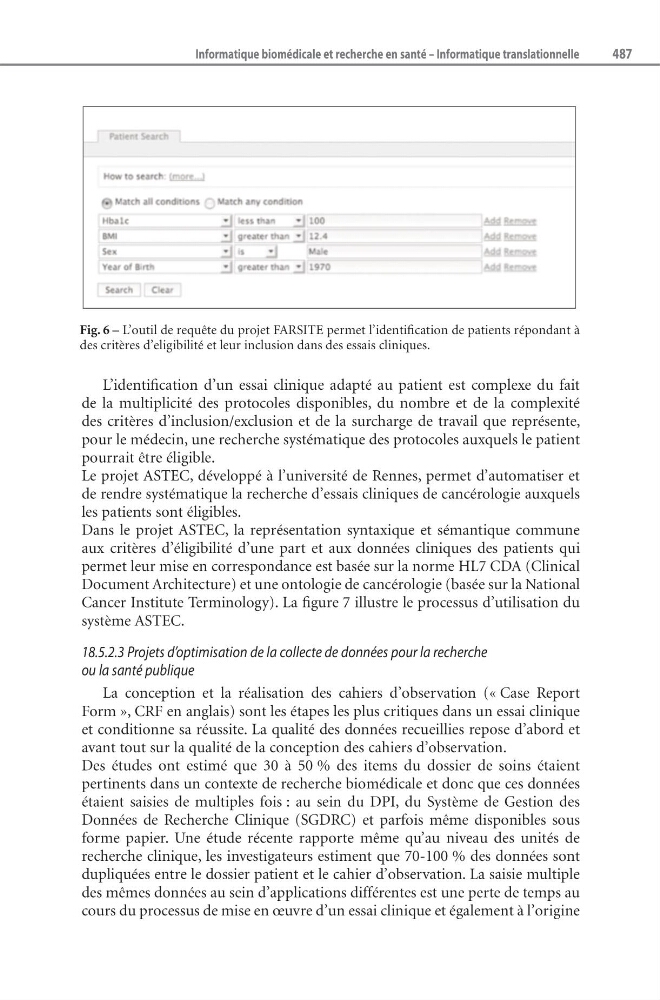
Fig. 6 – L’outil de requête du projet FARSITE permet l’identification de patients répondant à
des critères d’eligibilité et leur inclusion dans des essais cliniques.