

180
3 Hardware eingebetteter Systeme
Der Übergang auf spezialisierte Prozessoren erfolgt aufgrund von nachlassenden
Fortschritten in der Halbleiterfertigung und beim Entwurf von parallelen Prozessoren. Deshalb soll die Performanz nunmehr mit Spezialprozessoren erhöht werden.
Dies wurde mit Spezialprozessoren für das Maschinelle Lernen auch schon erreicht.
Im Jahr 2013 sagte Google vorher, dass es bald zu teuer werden würde, die
benötigte Rechenleistung für Mustererkennung (z.B. für Spracherkennung) in den
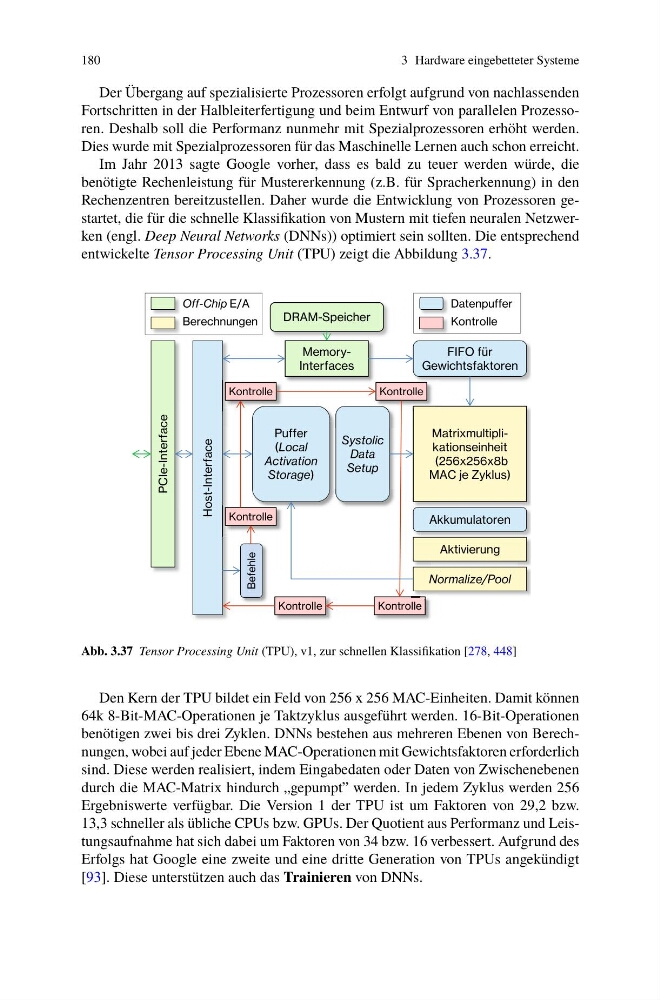
Rechenzentren bereitzustellen. Daher wurde die Entwicklung von Prozessoren gestartet, die für die schnelle Klassifikation von Mustern mit tiefen neuralen Netzwerken (engl. Deep Neural Networks (DNNs)) optimiert sein sollten. Die entsprechend
entwickelte Tensor Processing Unit (TPU) zeigt die Abbildung 3.37.
Matrixmultiplikationseinheit
(256x256x8b
MAC je Zyklus)
Akkumulatoren
Systolic
Data
Setup
Puffer
(Local
Activation
Storage)
FIFO für
Gewichtsfaktoren
Host-Interface
MemoryInterfaces
Kontrolle
Kontrolle
Kontrolle
Kontrolle
Kontrolle
PCIe-Interface
DRAM-Speicher
Aktivierung
Normalize/Pool
Befehle
Off-Chip E/A
Berechnungen
Datenpuffer
Kontrolle
Abb. 3.37 Tensor Processing Unit (TPU), v1, zur schnellen Klassifikation [278, 448]
Den Kern der TPU bildet ein Feld von 256 x 256 MAC-Einheiten. Damit können
64k 8-Bit-MAC-Operationen je Taktzyklus ausgeführt werden. 16-Bit-Operationen
benötigen zwei bis drei Zyklen. DNNs bestehen aus mehreren Ebenen von Berechnungen, wobei auf jeder Ebene MAC-Operationen mit Gewichtsfaktoren erforderlich
sind. Diese werden realisiert, indem Eingabedaten oder Daten von Zwischenebenen
durch die MAC-Matrix hindurch „gepumpt” werden. In jedem Zyklus werden 256
Ergebniswerte verfügbar. Die Version 1 der TPU ist um Faktoren von 29,2 bzw.
13,3 schneller als übliche CPUs bzw. GPUs. Der Quotient aus Performanz und Leistungsaufnahme hat sich dabei um Faktoren von 34 bzw. 16 verbessert. Aufgrund des
Erfolgs hat Google eine zweite und eine dritte Generation von TPUs angekündigt
[93]. Diese unterstützen auch das Trainieren von DNNs.