

28
1 Ce qu’on ne peut ignorer
10
−6
10
−5
10
−4
10
−3
10
−2
10
−1
10
−12
10
−10
10
−8
10
−6
10
−4
10
−2
10
0
1
1
1
2
0
0.02
0.04
0.06
0.08
0.1
0
0.01
0.02
0.03
0.04
0.05
0.06
0.07
0.08
0.09
0.1
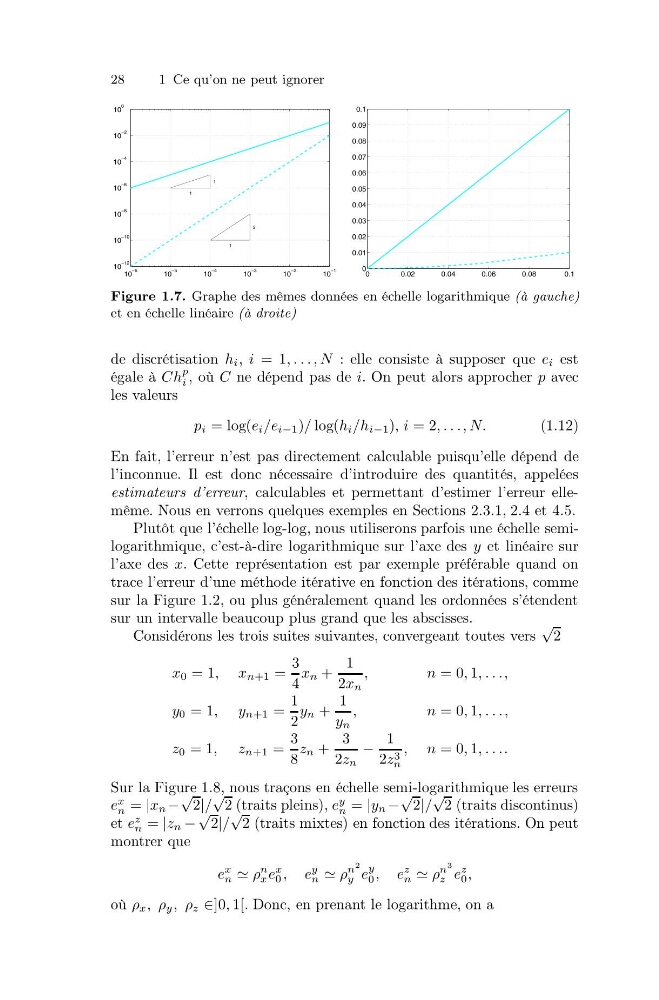
Figure 1.7. Graphe des mêmes données en échelle logarithmique (à gauche)
et en échelle linéaire (à droite)
de discrétisation h i , i = 1, . . . , N : elle consiste à supposer que e i est
égale à Ch
p
i , où C ne dépend pas de i. On peut alors approcher p avec
les valeurs
p i = log(e i /e i−1 )/ log(h i /h i−1 ), i = 2, . . ., N.
(1.12)
En fait, l’erreur n’est pas directement calculable puisqu’elle dépend de
l’inconnue. Il est donc nécessaire d’introduire des quantités, appelées
estimateurs d’erreur, calculables et permettant d’estimer l’erreur ellemême. Nous en verrons quelques exemples en Sections 2.3.1, 2.4 et 4.5.
Plutôt que l’échelle log-log, nous utiliserons parfois une échelle semilogarithmique, c’est-à-dire logarithmique sur l’axe des y et linéaire sur
l’axe des x. Cette représentation est par exemple préférable quand on
trace l’erreur d’une méthode itérative en fonction des itérations, comme
sur la Figure 1.2, ou plus généralement quand les ordonnées s’étendent
sur un intervalle beaucoup plus grand que les abscisses.
Considérons les trois suites suivantes, convergeant toutes vers
√
2
x 0 = 1, x n+1 =
3
4
x n +
1
2x n
,
n= 0, 1, . . .,
y 0 = 1, y n+1 =
1
2
y n +
1
y n
,
n= 0, 1, . . .,
z 0 = 1, z n+1 =
3
8
z n +
3
2z n
−
1
2z 3
n
, n = 0, 1, . . ..
Sur la Figure 1.8, nous traçons en échelle semi-logarithmique les erreurs
e
x
n = |x n −
√
2|/
√
2 (traits pleins), e
y
n = |y n −
√
2|/
√
2 (traits discontinus)
et e
z
n = |z n −
√
2|/
√
2 (traits mixtes) en fonction des itérations. On peut
montrer que
e
x
n ρ
n
x e
x
0 , e
y
n ρ
n
2
y e
y
0 , e
z
n ρ
n
3
z e
z
0 ,
où ρ x , ρ y , ρ z ∈]0, 1[. Donc, en prenant le logarithme, on a