

16. Régression logistique
303
•
y
∗
i = 0 si
π i < C
où C désigne une limite critique (par exemple C = 0.5). On va voir ci-dessous
comment on peut comparer les y i et les
y
∗
i en régression logistique afin de
mesurer la qualité globale de la prédiction.
Supposons (pour contextualiser notre discussion) que la variable réponse Y
représente une maladie (avec Y = 1 pour les malades et Y = 0 pour les nonmalades). Une valeur prédite peut alors être interprétée comme le résultat d’un
diagnostic que l’on établirait en utilisant notre modèle de régression logistique,
le diagnostic étant positif pour les individus avec
y
∗
i = 1 et négatif pour les
individus avec
y
∗
i = 0. Par ailleurs, les individus réellement malades sont ceux
avec y i = 1, les individus avec y i = 0 étant les non-malades. On peut alors
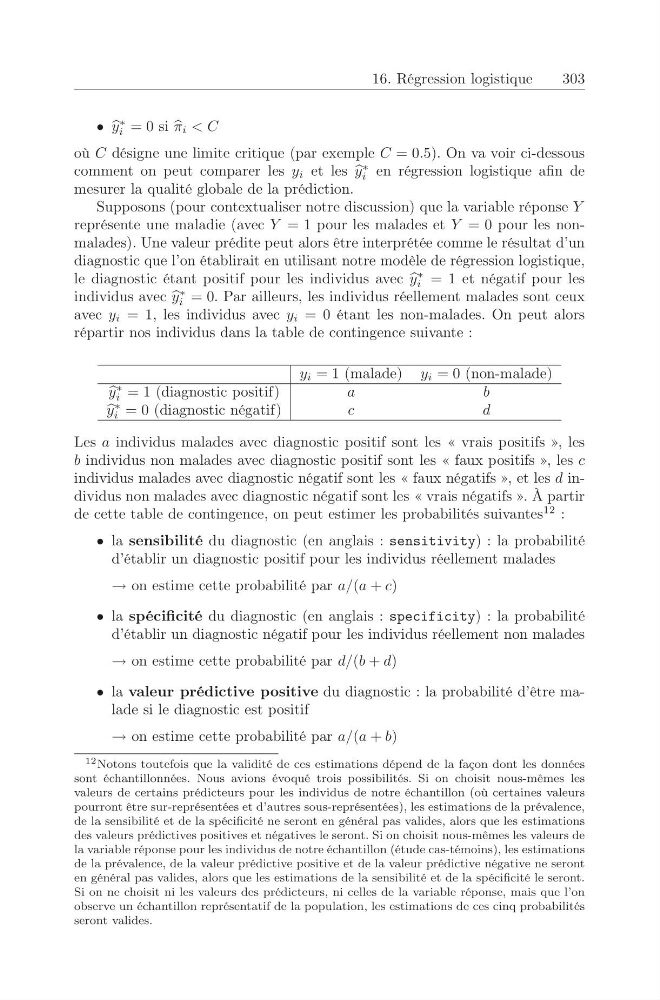
répartir nos individus dans la table de contingence suivante :
y i = 1 (malade) y i = 0 (non-malade)
y
∗
i = 1 (diagnostic positif)
a
b
y
∗
i = 0 (diagnostic négatif)
c
d
Les a individus malades avec diagnostic positif sont les « vrais positifs », les
b individus non malades avec diagnostic positif sont les « faux positifs », les c
individus malades avec diagnostic négatif sont les « faux négatifs », et les d individus non malades avec diagnostic négatif sont les « vrais négatifs ». À partir
de cette table de contingence, on peut estimer les probabilités suivantes
12 :
• la sensibilité du diagnostic (en anglais : sensitivity) : la probabilité
d’établir un diagnostic positif pour les individus réellement malades
→ on estime cette probabilité par a/(a + c)
• la spécificité du diagnostic (en anglais : specificity) : la probabilité
d’établir un diagnostic négatif pour les individus réellement non malades
→ on estime cette probabilité par d/(b + d)
• la valeur prédictive positive du diagnostic : la probabilité d’être malade si le diagnostic est positif
→ on estime cette probabilité par a/(a + b)
12 Notons toutefois que la validité de ces estimations dépend de la façon dont les données
sont échantillonnées. Nous avions évoqué trois possibilités. Si on choisit nous-mêmes les
valeurs de certains prédicteurs pour les individus de notre échantillon (où certaines valeurs
pourront être sur-représentées et d’autres sous-représentées), les estimations de la prévalence,
de la sensibilité et de la spécificité ne seront en général pas valides, alors que les estimations
des valeurs prédictives positives et négatives le seront. Si on choisit nous-mêmes les valeurs de
la variable réponse pour les individus de notre échantillon (étude cas-témoins), les estimations
de la prévalence, de la valeur prédictive positive et de la valeur prédictive négative ne seront
en général pas valides, alors que les estimations de la sensibilité et de la spécificité le seront.
Si on ne choisit ni les valeurs des prédicteurs, ni celles de la variable réponse, mais que l’on
observe un échantillon représentatif de la population, les estimations de ces cinq probabilités
seront valides.