

248
Statistique appliquée aux sciences de la vie
●
●
●
●
●
●
● ●
●
●
●
●●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
−50
0
50
0
5
10
15
perte de glucose
perte de poids
(a) cor= 0.44
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
−40
−20
0
20
40
60
0
5
10
15
perte de cholestérol
perte de poids
(b) cor= 0.5
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
−50
0
50
−40
0
20 40 60
perte de glucose
perte de cholestérol
(c) cor= 0.71
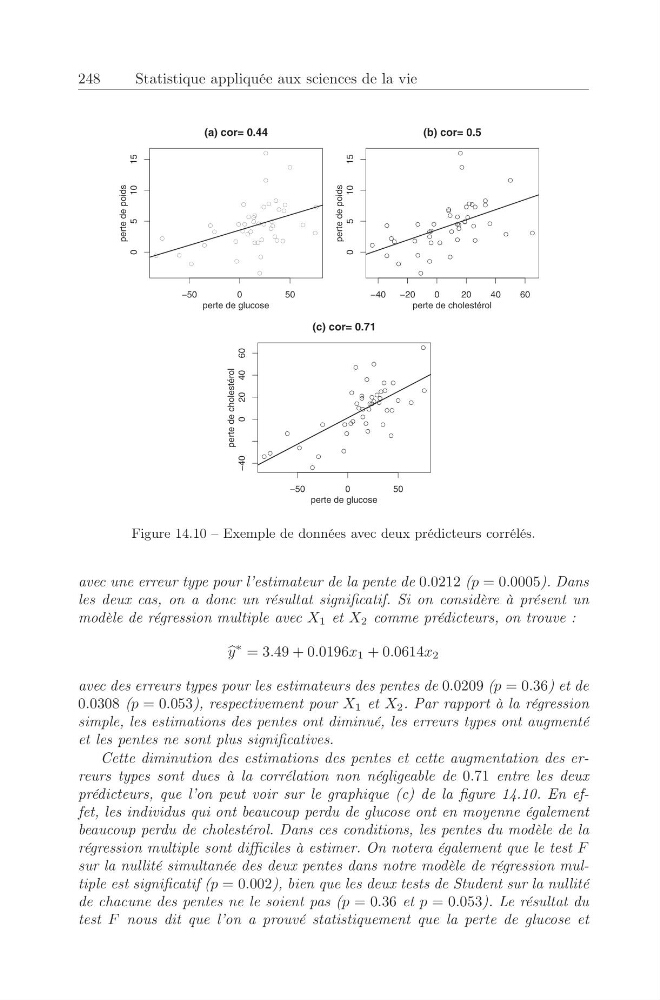
Figure 14.10 – Exemple de données avec deux prédicteurs corrélés.
avec une erreur type pour l’estimateur de la pente de 0.0212 (p = 0.0005). Dans
les deux cas, on a donc un résultat significatif. Si on considère à présent un
modèle de régression multiple avec X 1 et X 2 comme prédicteurs, on trouve :
y
∗ = 3.49 + 0.0196x 1 + 0.0614x 2
avec des erreurs types pour les estimateurs des pentes de 0.0209 (p = 0.36) et de
0.0308 (p = 0.053), respectivement pour X 1 et X 2 . Par rapport à la régression
simple, les estimations des pentes ont diminué, les erreurs types ont augmenté
et les pentes ne sont plus significatives.
Cette diminution des estimations des pentes et cette augmentation des erreurs types sont dues à la corrélation non négligeable de 0.71 entre les deux
prédicteurs, que l’on peut voir sur le graphique (c) de la figure 14.10. En effet, les individus qui ont beaucoup perdu de glucose ont en moyenne également
beaucoup perdu de cholestérol. Dans ces conditions, les pentes du modèle de la
régression multiple sont difficiles à estimer. On notera également que le test F
sur la nullité simultanée des deux pentes dans notre modèle de régression multiple est significatif (p = 0.002), bien que les deux tests de Student sur la nullité
de chacune des pentes ne le soient pas (p = 0.36 et p = 0.053). Le résultat du
test F nous dit que l’on a prouvé statistiquement que la perte de glucose et