

14. Régression linéaire multiple
221
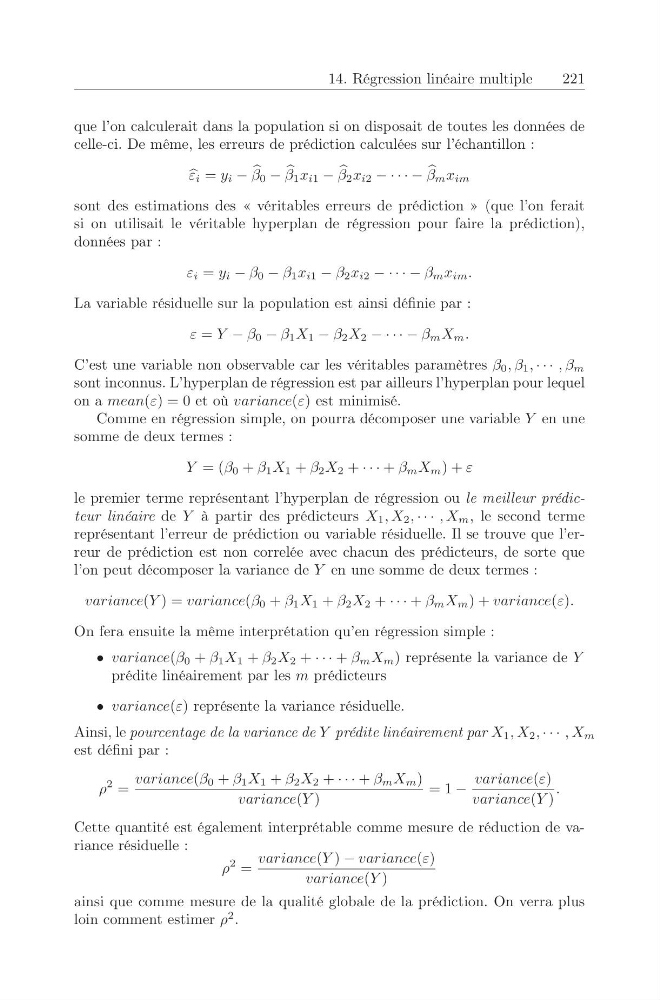
que l’on calculerait dans la population si on disposait de toutes les données de
celle-ci. De même, les erreurs de prédiction calculées sur l’échantillon :
ε i = y i −
β 0 −
β 1 x i1 −
β 2 x i2 − · · · −
β m x im
sont des estimations des « véritables erreurs de prédiction » (que l’on ferait
si on utilisait le véritable hyperplan de régression pour faire la prédiction),
données par :
ε i = y i − β 0 − β 1 x i1 − β 2 x i2 − · · · − β m x im .
La variable résiduelle sur la population est ainsi définie par :
ε = Y − β 0 − β 1 X 1 − β 2 X 2 − · · · − β m X m .
C’est une variable non observable car les véritables paramètres β 0 , β 1 , · · · , β m
sont inconnus. L’hyperplan de régression est par ailleurs l’hyperplan pour lequel
on a mean(ε) = 0 et où variance(ε) est minimisé.
Comme en régression simple, on pourra décomposer une variable Y en une
somme de deux termes :
Y = (β 0 + β 1 X 1 + β 2 X 2 + · · · + β m X m ) + ε
le premier terme représentant l’hyperplan de régression ou le meilleur prédicteur linéaire de Y à partir des prédicteurs X 1 , X 2 , · · · , X m , le second terme
représentant l’erreur de prédiction ou variable résiduelle. Il se trouve que l’erreur de prédiction est non correlée avec chacun des prédicteurs, de sorte que
l’on peut décomposer la variance de Y en une somme de deux termes :
variance(Y ) = variance(β 0 + β 1 X 1 + β 2 X 2 + · · · + β m X m ) + variance(ε).
On fera ensuite la même interprétation qu’en régression simple :
• variance(β 0 + β 1 X 1 + β 2 X 2 + · · · + β m X m ) représente la variance de Y
prédite linéairement par les m prédicteurs
• variance(ε) représente la variance résiduelle.
Ainsi, le pourcentage de la variance de Y prédite linéairement par X 1 , X 2 , · · · , X m
est défini par :
ρ
2 =
variance(β 0 + β 1 X 1 + β 2 X 2 + · · · + β m X m )
variance(Y )
= 1 −
variance(ε)
variance(Y )
.
Cette quantité est également interprétable comme mesure de réduction de variance résiduelle :
ρ
2 =
variance(Y ) − variance(ε)
variance(Y )
ainsi que comme mesure de la qualité globale de la prédiction. On verra plus
loin comment estimer ρ
2 .