

198
Statistique appliquée aux sciences de la vie
●
●
●
●
●
●
● ● ●
●
●
●
●
●
●
● ●
● ● ●
● ●
●
●
●
● ●
●
●
●
●
●
●
●
●
● ●
●
●
●
● ●
● ●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
● ●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
● ●
●
●
● ● ● ●
●
●
●
●
● ● ●
●
● ●
●
●
●
●
●
●
●
●
● ● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
(a) relation linéaire
●
● ●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
● ●
●
●
●
●
● ●
●
●
●
●
● ●
●
●
●
●
● ● ●
●
● ●
● ●
●
●
●
● ●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
● ●
●
●
●
●
● ●
●
●
●
● ●
● ●
●
●
●
●
● ●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
● ●
●
●
● ●
●
●
●
●
●
●
●
●
●
● ●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
● ● ●
● ● ●
●
●
●
●
●
●
●
● ● ● ●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
(b) relation non−linéaire
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
(c) relation linéaire
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
● ●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
●
(d) relation non−linéaire
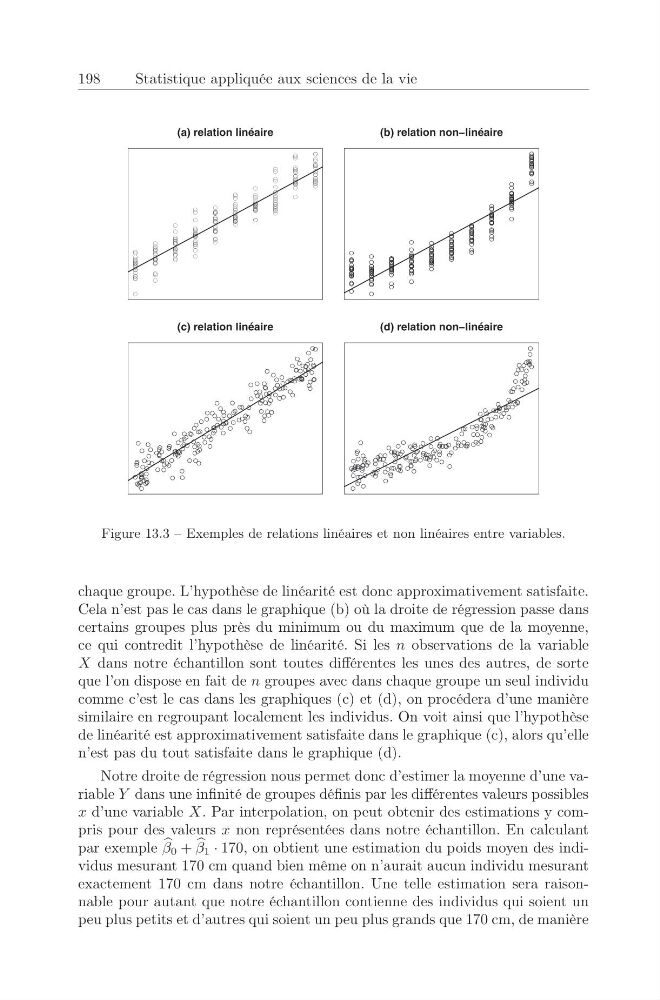
Figure 13.3 – Exemples de relations linéaires et non linéaires entre variables.
chaque groupe. L’hypothèse de linéarité est donc approximativement satisfaite.
Cela n’est pas le cas dans le graphique (b) où la droite de régression passe dans
certains groupes plus près du minimum ou du maximum que de la moyenne,
ce qui contredit l’hypothèse de linéarité. Si les n observations de la variable
X dans notre échantillon sont toutes différentes les unes des autres, de sorte
que l’on dispose en fait de n groupes avec dans chaque groupe un seul individu
comme c’est le cas dans les graphiques (c) et (d), on procédera d’une manière
similaire en regroupant localement les individus. On voit ainsi que l’hypothèse
de linéarité est approximativement satisfaite dans le graphique (c), alors qu’elle
n’est pas du tout satisfaite dans le graphique (d).
Notre droite de régression nous permet donc d’estimer la moyenne d’une variable Y dans une infinité de groupes définis par les différentes valeurs possibles
x d’une variable X. Par interpolation, on peut obtenir des estimations y compris pour des valeurs x non représentées dans notre échantillon. En calculant
par exemple
β 0 +
β 1 · 170, on obtient une estimation du poids moyen des individus mesurant 170 cm quand bien même on n’aurait aucun individu mesurant
exactement 170 cm dans notre échantillon. Une telle estimation sera raisonnable pour autant que notre échantillon contienne des individus qui soient un
peu plus petits et d’autres qui soient un peu plus grands que 170 cm, de manière