

Chapitre II : Modélisation du risque d’introduction des espèces non-indigènes par le
biofouling des coques des navires: Cas d’étude du port d’Arzew
78
Ici nous évaluons les performances prédictives du modèle ajusté aux données tropicales. Une
pratique courante consiste à diviser l'ensemble de données en un échantillon de 80:20 (données de
construction: données de test), puis à construire le modèle sur l'échantillon de 80 % et à utiliser le
modèle ainsi construit pour prédire la variable de réponse sur les données de test (20%). En
procédant de cette manière, nous aurons les valeurs prédites par le modèle pour les 20 % de
données (test). Nous pouvons alors voire comment le modèle se comportera avec ces "nouvelles"
données, en comparant ces valeurs prédites avec les valeurs originales. Nous pouvons également
vérifier la stabilité de la prédiction donnée par le modèle, en comparant ces valeurs prédites avec
celles obtenues précédemment, lorsque les données complètes ont été utilisées pour construire le
modèle (Fig.II-10).
La figure II-10, montre que la suppression d'une partie des données a un impact très faible sur les
prédictions (graphique de droite). D'autre part, la performance prédictive des modèles reste limitée
à cause de la variabilité naturelle des données (graphique de gauche) mais suffisante pour notre
prédiction. En effet, ces deux modèles construit avec l'échantillon d'entraînement explique 69% et
72 % de la variabilité du nouvel échantillon de test, respectivement pour les données tropicales et
tempérées ; ce qui est largement suffisant pour estimer le taux de couverture du fouling (Fig.II10).
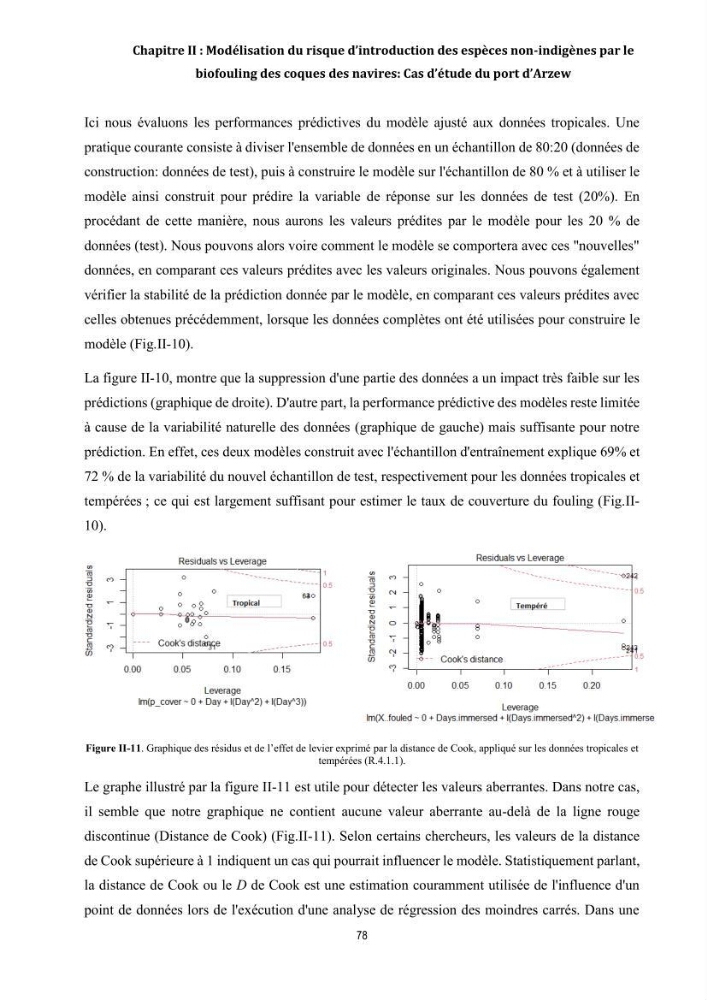
Figure II-11. Graphique des résidus et de l’effet de levier exprimé par la distance de Cook, appliqué sur les données tropicales et
tempérées (R.4.1.1).
Le graphe illustré par la figure II-11 est utile pour détecter les valeurs aberrantes. Dans notre cas,
il semble que notre graphique ne contient aucune valeur aberrante au-delà de la ligne rouge
discontinue (Distance de Cook) (Fig.II-11). Selon certains chercheurs, les valeurs de la distance
de Cook supérieure à 1 indiquent un cas qui pourrait influencer le modèle. Statistiquement parlant,
la distance de Cook ou le D de Cook est une estimation couramment utilisée de l'influence d'un
point de données lors de l'exécution d'une analyse de régression des moindres carrés. Dans une