

chapitre 21 Les génomes et leur évolution 499
Il existe une foule de ressources accessibles aux chercheurs
dans le monde entier. Penchons-nous maintenant sur les types
de questions que les scientifiques peuvent essayer de résoudre
à l’aide de ces ressources.
L’identification des gènes codant
pour des protéines et la compréhension
de leurs fonctions
À l’aide des séquences d’ADN disponibles, les généticiens
peuvent étudier les gènes directement sans avoir à inférer le
génotype du phénotype, comme on doit le faire en génétique classique. Mais cette approche, appelée génétique inverse,
pose un nouveau défi, car il faut déterminer le phénotype à
partir du génotype. À partir d’une longue séquence d’ADN
fournie par une base de données comme GenBank, l’objectif
des scientifiques consiste à identifier tous les gènes qui
codent pour des protéines dans la séquence et, finalement,
à déterminer leurs fonctions. Ce processus est appelé annotation d’un gène.
Par le passé, l’annotation d’un gène était réalisée péniblement par des scientifiques qui s’intéressaient personnellement
à des gènes particuliers, mais le processus est maintenant
largement automatisé. La démarche habituelle consiste à se
servir de logiciels pour parcourir les séquences stockées et
rechercher celles qui sont associées aux signaux de départ et
d’arrêt de la transcription et de la traduction, ainsi qu’aux sites
d’épissage de l’ARN ; il est également possible de trouver
d’autres indices de la présence de gènes codant pour des protéines. Ces logiciels permettent également de repérer certaines
courtes séquences qui codent pour des ARNm connus. Des
milliers de séquences de ce type, appelées étiquettes de séquences
exprimées (ou EST, pour expressed sequences tags), ont été collectées à partir de séquences d’ADNc et sont actuellement
répertoriées dans des bases de données informatisées. Ce type
d’analyse détermine les séquences qui pourraient correspondre
à des gènes codant pour des protéines auparavant inconnus.
Avant le début du Projet génome humain, on avait déjà
identifié près de la moitié des gènes humains. Mais qu’en est-il
de ceux qu’on ne connaissait pas encore et que l’analyse des
séquences d’ADN a révélés ? On obtient des indices de leur
identité et de leurs fonctions en comparant des séquences
nucléotidiques susceptibles d’être des gènes avec des gènes
connus provenant d’autres organismes, à l’aide du logiciel
décrit précédemment. En raison des redondances du code
génétique, la séquence de l’ADN elle-même peut varier plus
WD40 - Cn3D 4.1
CDD Description
WD40- Visionneuse de l’alignement des séquences
Le domaine WD40, présent dans de
nombreuses protéines eucaryotes qui
couvrent une grande variété de fonctions
dont des modules adaptateur/régulateur
dans la transduction des signaux,
la maturation de l’ARN prémessager
et l’assemblage du cytosquelette,
contient généralement un dipeptide
GH de 11-24 résidus à son extrémité
N-terminale et le dipeptide WD à son
extrémité C-terminale et a une longueur
de 40 résidus, d’où son nom WD40;
Nom : WD40
9DFKH>WUDQVGXFLQH@
0RXWDUGH>WUDQVGXFLQH@
0DwV>SURWpLQH*1%@
+XPDLQ>SURWpLQH3$)$@
1pPDWRGH>SURWpLQHLQFRQQXHQ
R
@
1pPDWRGH>SURWpLQHLQFRQQXHQ
R
@
/HYXUHjILVVLRQ>SURWpLQH):'5@
aQYUY65(/$a*+WJ\/6&&5)/'GaaQ4,97Vaa6Ja'77&$/:'LHa
JWYSY650/7a*+UJ\96&&4<93QHGD+/,7Vaa6Ja'47&,/:'YWW
JQPSY65,/7a*+NJ\966&4<93GJHW5/,76aa6Ja'47&9/:'YWa
aaaHF,570+a*+GKQ9669$,03QJaG+,96$aa6Ua'.7,.0:(YJa
aaaUF9.7/.a*+WQ\9)&&&)13VaaJ7/,$6aa*VI'(7,5,:&DUa
aaaUP7.7/.a*+QQ\9)&&1)13TaaV6/996aa*VI'(695,:'YNa
aaaVH&,6,/K*+WGV9/&/7)'6aaaa7//96aa*VD'&79./:+IVa
aaaNW**,5/a5+INV96$9(:+5NaaJ' 5HFKHUFKH
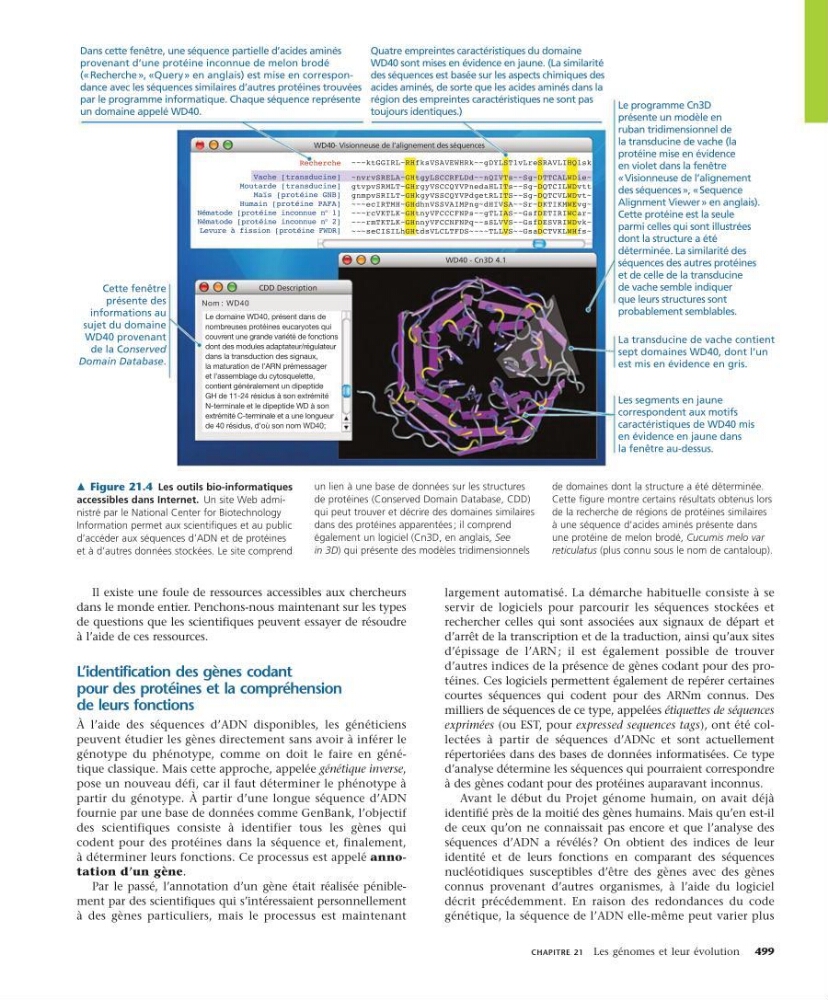
Quatre empreintes caractéristiques du domaine
WD40 sont mises en évidence en jaune. (La similarité
des séquences est basée sur les aspects chimiques des
acides aminés, de sorte que les acides aminés dans la
région des empreintes caractéristiques ne sont pas
toujours identiques.)
Dans cette fenêtre, une séquence partielle d’acides aminés
provenant d’une protéine inconnue de melon brodé
(«Recherche », «Query» en anglais) est mise en correspondance avec les séquences similaires d’autres protéines trouvées
par le programme informatique. Chaque séquence représente
un domaine appelé WD40.
La transducine de vache contient
sept domaines WD40, dont l’un
est mis en évidence en gris.
Les segments en jaune
correspondent aux motifs
caractéristiques de WD40 mis
en évidence en jaune dans
la fenêtre au-dessus.
Cette fenêtre
présente des
informations au
sujet du domaine
WD40 provenant
de la Conserved
Domain Database.
Le programme Cn3D
présente un modèle en
ruban tridimensionnel de
la transducine de vache (la
protéine mise en évidence
en violet dans la fenêtre
« Visionneuse de l’alignement
des séquences», «Sequence
Alignment Viewer» en anglais).
Cette protéine est la seule
parmi celles qui sont illustrées
dont la structure a été
déterminée. La similarité des
séquences des autres protéines
et de celle de la transducine
de vache semble indiquer
que leurs structures sont
probablement semblables.
m Figure 21.4 Les outils bio-informatiques
accessibles dans Internet. Un site Web administré par le National Center for Biotechnology
Information permet aux scientifiques et au public
d’accéder aux séquences d’ADN et de protéines
et à d’autres données stockées. Le site comprend
un lien à une base de données sur les structures
de protéines (Conserved Domain Database, CDD)
qui peut trouver et décrire des domaines similaires
dans des protéines apparentées ; il comprend
également un logiciel (Cn3D, en anglais, See
in 3D) qui présente des modèles tridimensionnels
de domaines dont la structure a été déterminée.
Cette figure montre certains résultats obtenus lors
de la recherche de régions de protéines similaires
à une séquence d’acides aminés présente dans
une protéine de melon brodé, Cucumis melo var
reticulatus (plus connu sous le nom de cantaloup).