

382 trOiSiÈMe partie La génétique
mots composés chacun de trois nucléotides d’ADN qui ne se
chevauchent pas. La série de mots dans un gène est transcrite
en une série complémentaire de mots composés chacun de
trois nucléotides dans l’ARNm, qui est ensuite traduite en
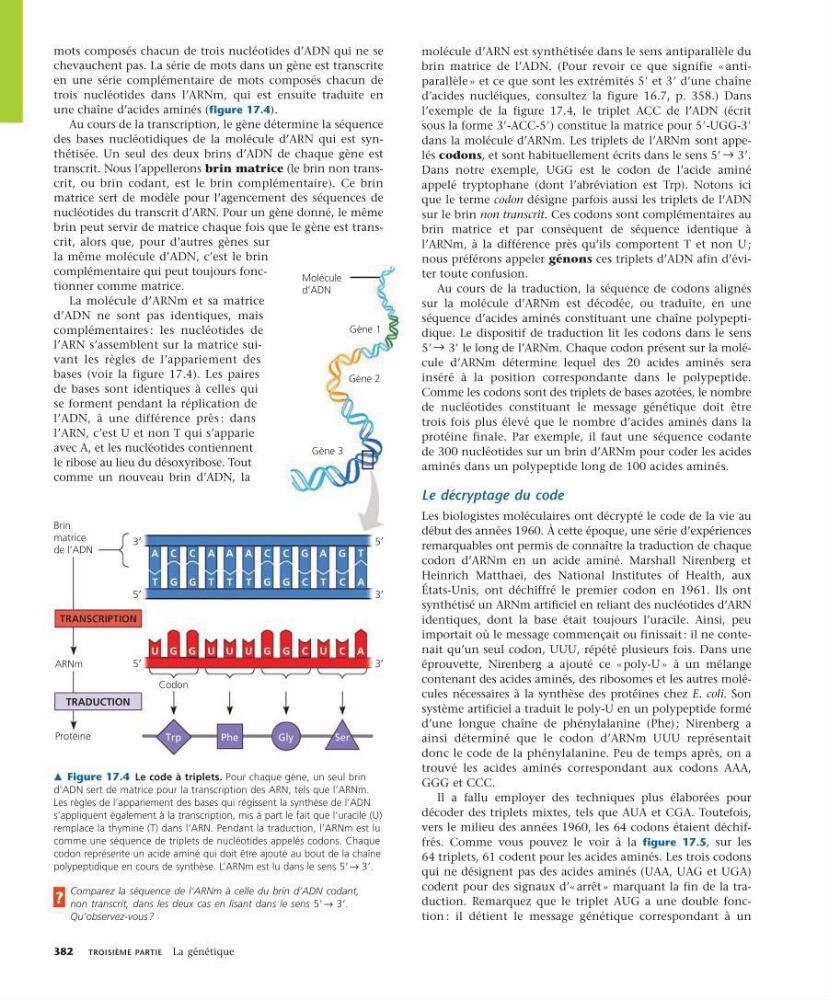
une chaîne d’acides aminés (figure 17.4).
Au cours de la transcription, le gène détermine la séquence
des bases nucléotidiques de la molécule d’ARN qui est synthétisée. Un seul des deux brins d’ADN de chaque gène est
transcrit. Nous l’appellerons brin matrice (le brin non transcrit, ou brin codant, est le brin complémentaire). Ce brin
matrice sert de modèle pour l’agencement des séquences de
nucléotides du transcrit d’ARN. Pour un gène donné, le même
brin peut servir de matrice chaque fois que le gène est transcrit, alors que, pour d’autres gènes sur
la même molécule d’ADN, c’est le brin
complémentaire qui peut toujours fonctionner comme matrice.
La molécule d’ARNm et sa matrice
d’ADN ne sont pas identiques, mais
complémentaires : les nucléotides de
l’ARN s’assemblent sur la matrice suivant les règles de l’appariement des
bases (voir la figure 17.4). Les paires
de bases sont identiques à celles qui
se forment pendant la réplication de
l’ADN, à une différence près : dans
l’ARN, c’est U et non T qui s’apparie
avec A, et les nucléotides contiennent
le ribose au lieu du désoxyribose. Tout
comme un nouveau brin d’ADN, la
molécule d’ARN est synthétisée dans le sens antipa rallèle du
brin matrice de l’ADN. (Pour revoir ce que signifie « antiparallèle » et ce que sont les extrémités 59 et 39 d’une chaîne
d’acides nucléiques, consultez la figure 16.7, p. 358.) Dans
l’exemple de la figure 17.4, le triplet ACC de l’ADN (écrit
sous la forme 39-ACC-59) constitue la matrice pour 59-UGG-39
dans la molécule d’ARNm. Les triplets de l’ARNm sont appelés codons, et sont habituellement écrits dans le sens 59 → 39.
Dans notre exemple, UGG est le codon de l’acide aminé
appelé tryptophane (dont l’abréviation est Trp). Notons ici
que le terme codon désigne parfois aussi les triplets de l’ADN
sur le brin non transcrit. Ces codons sont complémentaires au
brin matrice et par conséquent de séquence identique à
l’ARNm, à la différence près qu’ils comportent T et non U ;
nous préférons appeler génons ces triplets d’ADN afin d’éviter toute confusion.
Au cours de la traduction, la séquence de codons alignés
sur la molécule d’ARNm est décodée, ou traduite, en une
séquence d’acides aminés constituant une chaîne polypeptidique. Le dispositif de traduction lit les codons dans le sens
59 → 39 le long de l’ARNm. Chaque codon présent sur la molécule d’ARNm détermine lequel des 20 acides aminés sera
inséré à la position correspondante dans le polypeptide.
Comme les codons sont des triplets de bases azotées, le nombre
de nucléotides constituant le message génétique doit être
trois fois plus élevé que le nombre d’acides aminés dans la
protéine finale. Par exemple, il faut une séquence codante
de 300 nucléotides sur un brin d’ARNm pour coder les acides
aminés dans un polypeptide long de 100 acides aminés.
Le décryptage du code
Les biologistes moléculaires ont décrypté le code de la vie au
début des années 1960. À cette époque, une série d’expé riences
remarquables ont permis de connaître la traduction de chaque
codon d’ARNm en un acide aminé. Marshall Nirenberg et
Heinrich Matthaei, des National Institutes of Health, aux
États-Unis, ont déchiffré le premier codon en 1961. Ils ont
synthétisé un ARNm artificiel en reliant des nucléotides d’ARN
identiques, dont la base était toujours l’uracile. Ainsi, peu
importait où le message commençait ou finissait : il ne contenait qu’un seul codon, UUU, répété plusieurs fois. Dans une
éprouvette, Nirenberg a ajouté ce « poly-U » à un mélange
contenant des acides aminés, des ribosomes et les autres molécules nécessaires à la synthèse des protéines chez E. coli. Son
système artificiel a traduit le poly-U en un polypeptide formé
d’une longue chaîne de phénylalanine (Phe) ; Nirenberg a
ainsi déterminé que le codon d’ARNm UUU représentait
donc le code de la phénylalanine. Peu de temps après, on a
trouvé les acides aminés correspondant aux codons AAA,
GGG et CCC.
Il a fallu employer des techniques plus élaborées pour
décoder des triplets mixtes, tels que AUA et CGA. Toutefois,
vers le milieu des années 1960, les 64 codons étaient déchiffrés. Comme vous pouvez le voir à la figure 17.5, sur les
64 triplets, 61 codent pour les acides aminés. Les trois codons
qui ne désignent pas des acides aminés (UAA, UAG et UGA)
codent pour des signaux d’« arrêt » marquant la fin de la traduction. Remarquez que le triplet AUG a une double fonction : il détient le message génétique correspondant à un
m Figure 17.4 Le code à triplets. Pour chaque gène, un seul brin
d’ADN sert de matrice pour la transcription des ARN, tels que l’ARNm.
Les règles de l’appariement des bases qui régissent la synthèse de l’ADN
s’appliquent également à la transcription, mis à part le fait que l’uracile (U)
remplace la thymine (T) dans l’ARN. Pendant la traduction, l’ARNm est lu
comme une séquence de triplets de nucléotides appelés codons. Chaque
codon représente un acide aminé qui doit être ajouté au bout de la chaîne
polypeptidique en cours de synthèse. L’ARNm est lu dans le sens 59 → 39.
Comparez la séquence de l’ARNm à celle du brin d’ADN codant,
non transcrit, dans les deux cas en lisant dans le sens 59 → 39.
Qu’observez-vous ?
?
5′
3′
3′
5′
3′
U G G U U
U
U G G C
C A
Trp
Phe
Gly
Ser
Brin
matrice
de l’ADN
Codon
5′
A C
A A A C
G T
A
C
G
C
G
T
T
T
G
C
G
C
G
T
A
T
Protéine
ARNm
Gène 1
Molécule
d’ADN
Gène 2
Gène 3
TRANSCRIPTION
TRADUCTION