

© Dunod – Toute reproduction non autorisée est un délit.
35
4.1 • Score de similitude entre séquences
Une question importante pour juger du score est : « Combien de fois le score Sr
est attendu par hasard ? »
Pour deux séquences de longueurs
, on peut calculer la E-value notée E()
n m
et
comme le nombre de fois que deux séquences auront par chance un score supérieur
ou égal à Sr (ou un score normalisé S bit ) :
E() = K.m.n.
où K et sont des constantes.
En utilisant le S bit la relation devient :
E() = m.n.2
–Sbit
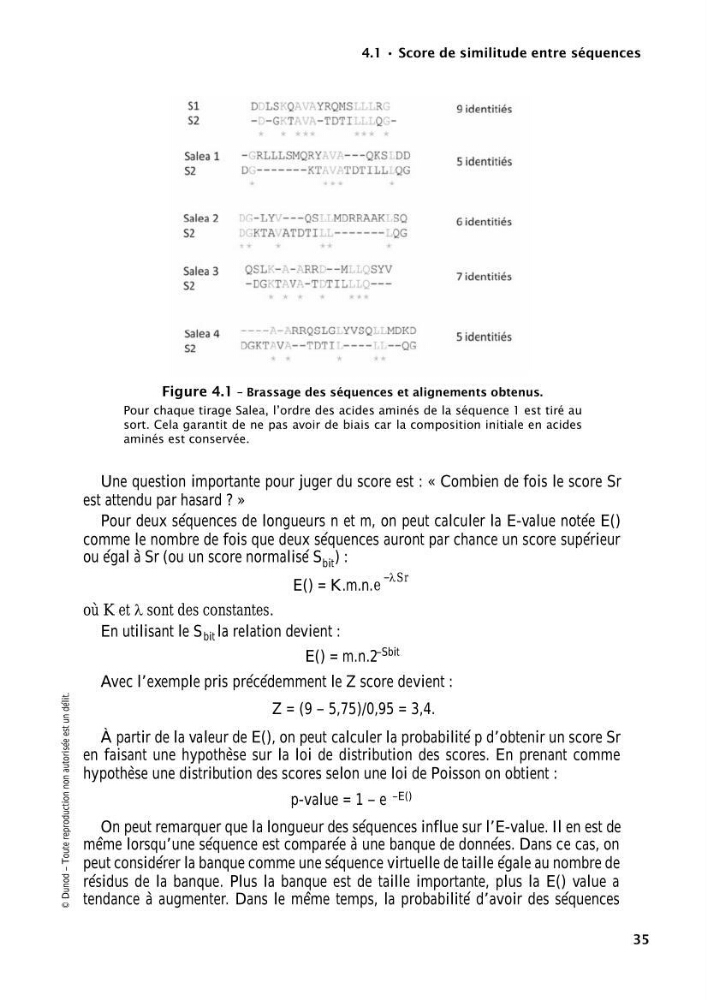
Avec l’exemple pris précédemment le Z score devient :
Z = (9 – 5,75)/0,95 = 3,4.
À partir de la valeur de E(), on peut calculer la probabilité p d’obtenir un score Sr
en faisant une hypothèse sur la loi de distribution des scores. En prenant comme
hypothèse une distribution des scores selon une loi de Poisson on obtient :
p-value = 1 – e –E()
On peut remarquer que la longueur des séquences influe sur l’E-value. Il en est de
même lorsqu’une séquence est comparée à une banque de données. Dans ce cas, on
peut considérer la banque comme une séquence virtuelle de taille égale au nombre de
résidus de la banque. Plus la banque est de taille importante, plus la E() value a
tendance à augmenter. Dans le même temps, la probabilité d’avoir des séquences
Figure 4.1 – Brassage des séquences et alignements obtenus.
Pour chaque tirage Salea, l’ordre des acides aminés de la séquence 1 est tiré au
sort. Cela garantit de ne pas avoir de biais car la composition initiale en acides
aminés est conservée.
e
Sr
–