

© Dunod – Toute reproduction non autorisée est un délit.
109
8.4 • Méthodes à base de profils
connaissant l’état S i , la probabilité d’avoir l’état S i+1 est P(S i+1 |P i ) et ne dépend que
de l’état précédent (pour une chaîne d’ordre 1). Le formalisme concernant les
chaînes de Markov est assez lourd surtout quand on considère qu’en général en
biologie des chaînes d’ordre supérieur sont nécessaires. Les HMM sont utilisés
dans de nombreux contextes bioinformatiques (recherche de motifs, recherche
d’intron/exon, exploitation d’alignements multiples) et donne un cadre statistiquement robuste pour la modélisation des séquences. Ils sont de plus en plus
utilisés en bioinformatique.
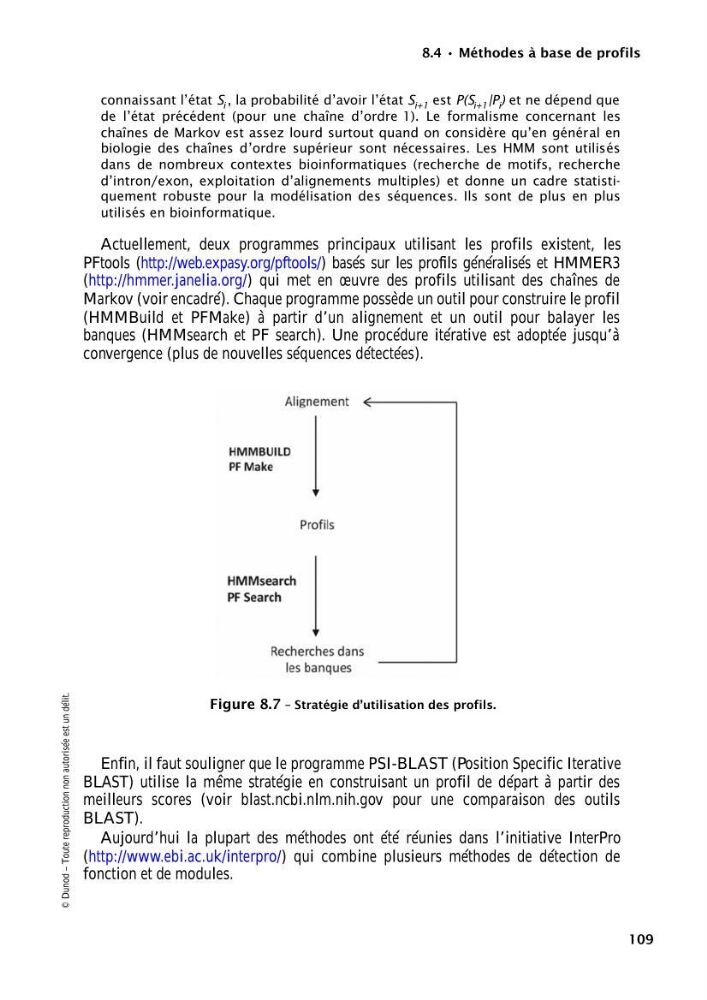
Actuellement, deux programmes principaux utilisant les profils existent, les
PFtools (http://web.expasy.org/pftools/) basés sur les profils généralisés et HMMER3
(http://hmmer.janelia.org/) qui met en œuvre des profils utilisant des chaînes de
Markov (voir encadré). Chaque programme possède un outil pour construire le profil
(HMMBuild et PFMake) à partir d’un alignement et un outil pour balayer les
banques (HMMsearch et PF search). Une procédure itérative est adoptée jusqu’à
convergence (plus de nouvelles séquences détectées).
Enfin, il faut souligner que le programme PSI-BLAST (Position Specific Iterative
BLAST) utilise la même stratégie en construisant un profil de départ à partir des
meilleurs scores (voir blast.ncbi.nlm.nih.gov pour une comparaison des outils
BLAST).
Aujourd’hui la plupart des méthodes ont été réunies dans l’initiative InterPro
(http://www.ebi.ac.uk/interpro/) qui combine plusieurs méthodes de détection de
fonction et de modules.
Figure 8.7 – Stratégie d’utilisation des profils.