

3.9 La normalisation
47
© Dunod – La photocopie non autorisée est un délit.
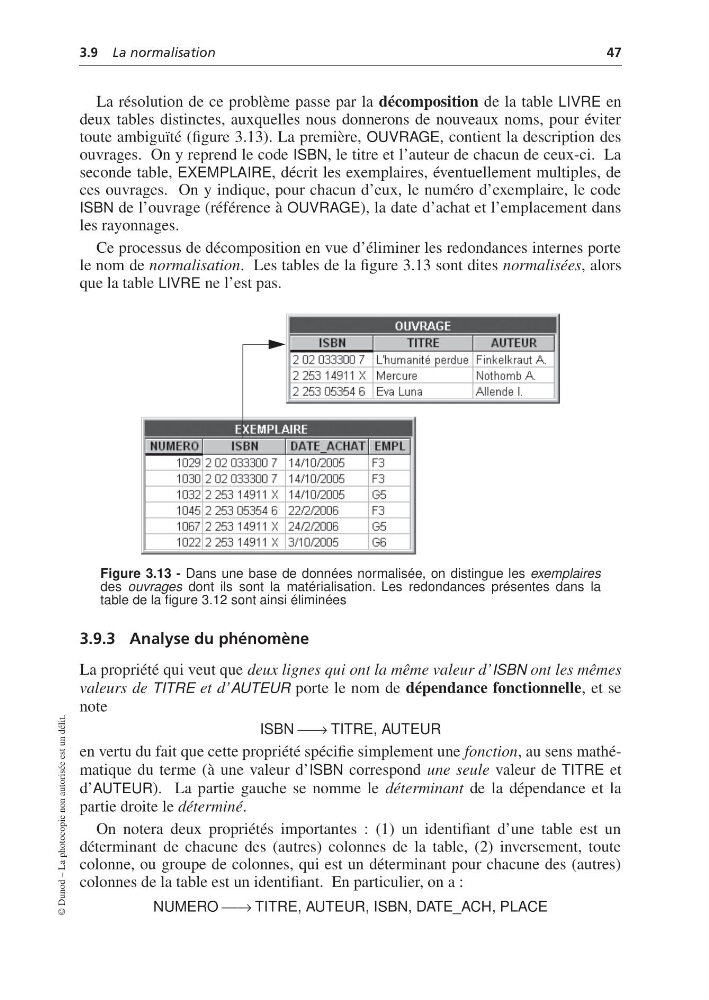
La résolution de ce problème passe par la décomposition de la table LIVRE en
deux tables distinctes, auxquelles nous donnerons de nouveaux noms, pour éviter
toute ambiguïté (figure 3.13). La première, OUVRAGE, contient la description des
ouvrages. On y reprend le code ISBN, le titre et l’auteur de chacun de ceux-ci. La
seconde table, EXEMPLAIRE, décrit les exemplaires, éventuellement multiples, de
ces ouvrages. On y indique, pour chacun d’eux, le numéro d’exemplaire, le code
ISBN de l’ouvrage (référence à OUVRAGE), la date d’achat et l’emplacement dans
les rayonnages.
Ce processus de décomposition en vue d’éliminer les redondances internes porte
le nom de normalisation. Les tables de la figure 3.13 sont dites normalisées, alors
que la table LIVRE ne l’est pas.
Figure 3.13 - Dans une base de données normalisée, on distingue les exemplaires
des ouvrages dont ils sont la matérialisation. Les redondances présentes dans la
table de la figure 3.12 sont ainsi éliminées
3.9.3 Analyse du phénomène
La propriété qui veut que deux lignes qui ont la même valeur d’ISBN ont les mêmes
valeurs de TITRE et d’AUTEUR porte le nom de dépendance fonctionnelle, et se
note
ISBN → TITRE, AUTEUR
en vertu du fait que cette propriété spécifie simplement une fonction, au sens mathématique du terme (à une valeur d’ISBN correspond une seule valeur de TITRE et
d’AUTEUR). La partie gauche se nomme le déterminant de la dépendance et la
partie droite le déterminé.
On notera deux propriétés importantes : (1) un identifiant d’une table est un
déterminant de chacune des (autres) colonnes de la table, (2) inversement, toute
colonne, ou groupe de colonnes, qui est un déterminant pour chacune des (autres)
colonnes de la table est un identifiant. En particulier, on a :
NUMERO → TITRE, AUTEUR, ISBN, DATE_ACH, PLACE