

295
9.2 Maîtrise de la compilation
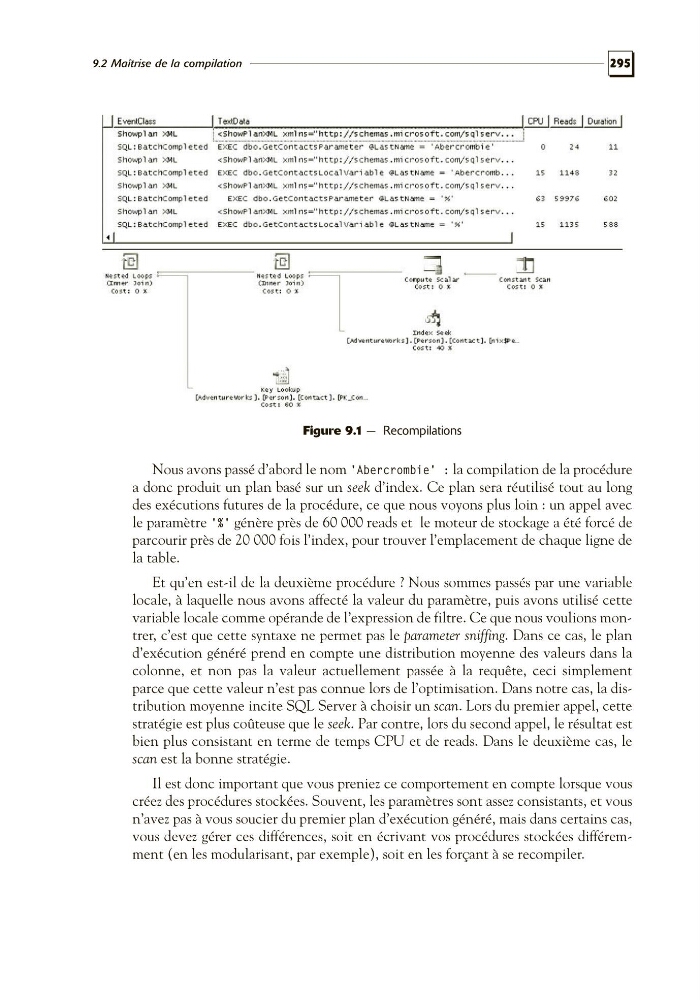
Figure 9.1 — Recompilations
Nous avons passé d’abord le nom 'Abercrombie' : la compilation de la procédure
a donc produit un plan basé sur un seek d’index. Ce plan sera réutilisé tout au long
des exécutions futures de la procédure, ce que nous voyons plus loin : un appel avec
le paramètre '%' génère près de 60 000 reads et le moteur de stockage a été forcé de
parcourir près de 20 000 fois l’index, pour trouver l’emplacement de chaque ligne de
la table.
Et qu’en est-il de la deuxième procédure ? Nous sommes passés par une variable
locale, à laquelle nous avons affecté la valeur du paramètre, puis avons utilisé cette
variable locale comme opérande de l’expression de filtre. Ce que nous voulions montrer, c’est que cette syntaxe ne permet pas le parameter sniffing. Dans ce cas, le plan
d’exécution généré prend en compte une distribution moyenne des valeurs dans la
colonne, et non pas la valeur actuellement passée à la requête, ceci simplement
parce que cette valeur n’est pas connue lors de l’optimisation. Dans notre cas, la distribution moyenne incite SQL Server à choisir un scan. Lors du premier appel, cette
stratégie est plus coûteuse que le seek. Par contre, lors du second appel, le résultat est
bien plus consistant en terme de temps CPU et de reads. Dans le deuxième cas, le
scan est la bonne stratégie.
Il est donc important que vous preniez ce comportement en compte lorsque vous
créez des procédures stockées. Souvent, les paramètres sont assez consistants, et vous
n’avez pas à vous soucier du premier plan d’exécution généré, mais dans certains cas,
vous devez gérer ces différences, soit en écrivant vos procédures stockées différemment (en les modularisant, par exemple), soit en les forçant à se recompiler.