

252
Chapitre 8. Optimisation du code SQL
Bookmark Lookup – recherche de lignes dans une table après parcours ou
recherche dans un index nonclustered, à l’aide d’une clé d’index clustered ou d’un
RowID. Le bookmark lookup est le plus souvent exprimé dans le plan soit par un opérateur Key Lookup, soit par un opérateur RID Lookup.
Clustered Index Scan – parcours du nœud feuille d’un index clustered, donc de la
table elle-même.
Clustered Index Seek – recherche dans un index clustered. Cette recherche n’est
jamais suivie d’un bookmark lookup, puisque la table fait partie de l’index clustered.
Split et Collapse – ces opérateurs se rencontrent dans certaines mises à jour
(UPDATE) où une contrainte d’unicité doit être vérifiée. Un UPDATE seul sur une
colonne avec contrainte unique pourrait déboucher sur l’insertion de doublons,
parce que la mise à jour est exécutée ligne par ligne par le moteur de stockage. Il faut
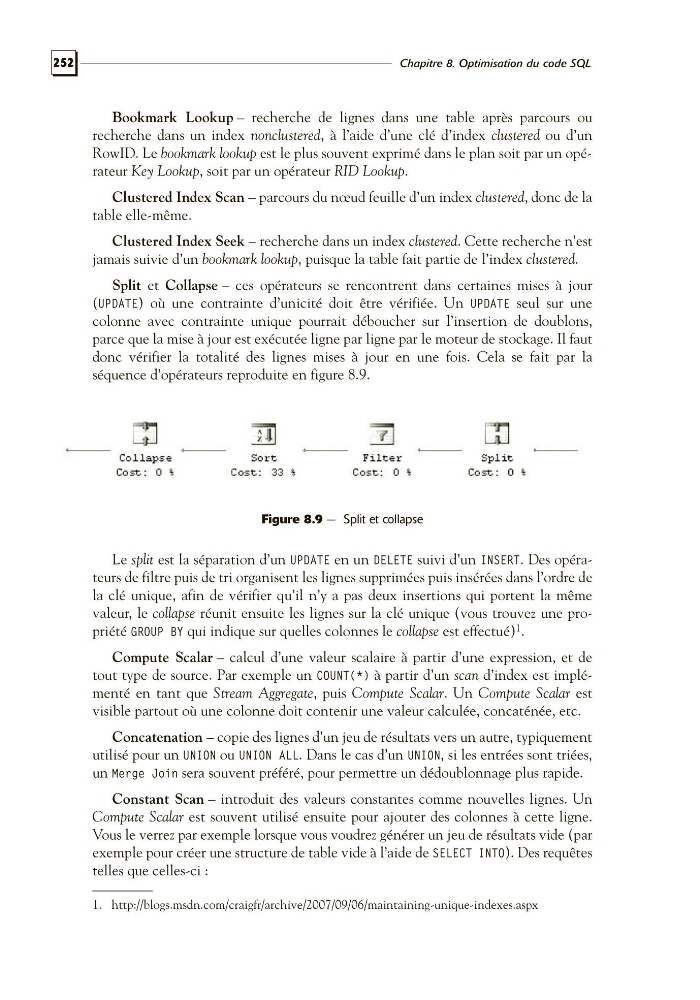
donc vérifier la totalité des lignes mises à jour en une fois. Cela se fait par la
séquence d’opérateurs reproduite en figure 8.9.
Figure 8.9 — Split et collapse
Le split est la séparation d’un UPDATE en un DELETE suivi d’un INSERT. Des opérateurs de filtre puis de tri organisent les lignes supprimées puis insérées dans l’ordre de
la clé unique, afin de vérifier qu’il n’y a pas deux insertions qui portent la même
valeur, le collapse réunit ensuite les lignes sur la clé unique (vous trouvez une propriété GROUP BY qui indique sur quelles colonnes le collapse est effectué) 1 .
Compute Scalar – calcul d’une valeur scalaire à partir d’une expression, et de
tout type de source. Par exemple un COUNT(*) à partir d’un scan d’index est implémenté en tant que Stream Aggregate, puis Compute Scalar. Un Compute Scalar est
visible partout où une colonne doit contenir une valeur calculée, concaténée, etc.
Concatenation – copie des lignes d’un jeu de résultats vers un autre, typiquement
utilisé pour un UNION ou UNION ALL. Dans le cas d’un UNION, si les entrées sont triées,
un Merge Join sera souvent préféré, pour permettre un dédoublonnage plus rapide.
Constant Scan – introduit des valeurs constantes comme nouvelles lignes. Un
Compute Scalar est souvent utilisé ensuite pour ajouter des colonnes à cette ligne.
Vous le verrez par exemple lorsque vous voudrez générer un jeu de résultats vide (par
exemple pour créer une structure de table vide à l’aide de SELECT INTO). Des requêtes
telles que celles-ci :
1. http://blogs.msdn.com/craigfr/archive/2007/09/06/maintaining-unique-indexes.aspx