

246
Chapitre 8. Optimisation du code SQL
Il peut exister au plus deux versions d’un même plan en cache : une version
monoprocesseur et une version parallélisée. SQL Server choisit d’utiliser l’un ou
l’autre selon la charge des CPU à l’exécution. Si le plan parallélisé est choisi, tous les
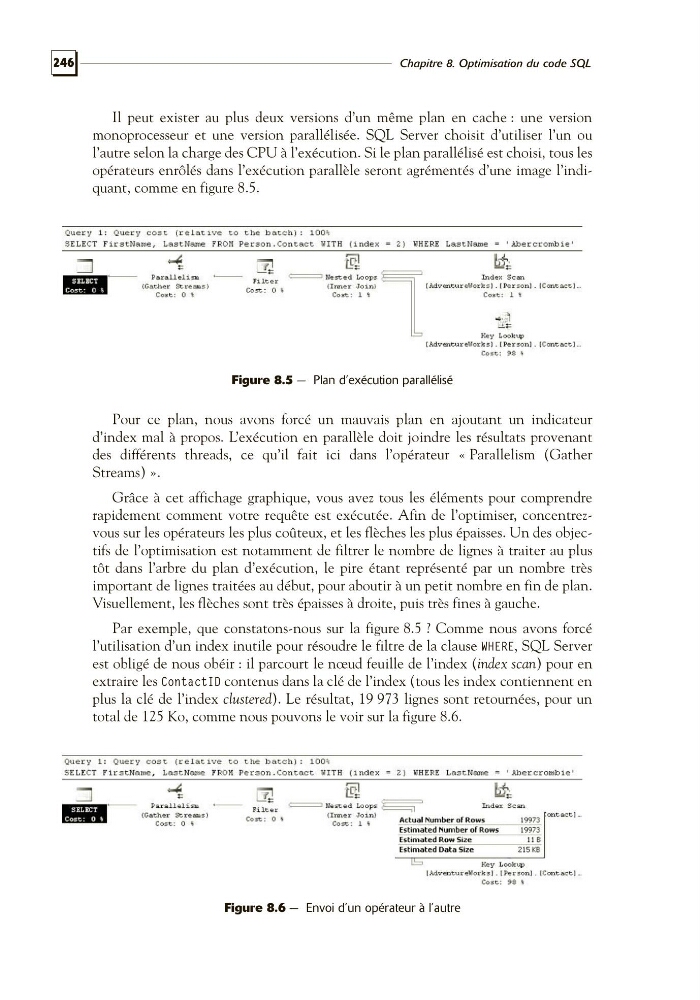
opérateurs enrôlés dans l’exécution parallèle seront agrémentés d’une image l’indiquant, comme en figure 8.5.
Figure 8.5 — Plan d’exécution parallélisé
Pour ce plan, nous avons forcé un mauvais plan en ajoutant un indicateur
d’index mal à propos. L’exécution en parallèle doit joindre les résultats provenant
des différents threads, ce qu’il fait ici dans l’opérateur « Parallelism (Gather
Streams) ».
Grâce à cet affichage graphique, vous avez tous les éléments pour comprendre
rapidement comment votre requête est exécutée. Afin de l’optimiser, concentrezvous sur les opérateurs les plus coûteux, et les flèches les plus épaisses. Un des objectifs de l’optimisation est notamment de filtrer le nombre de lignes à traiter au plus
tôt dans l’arbre du plan d’exécution, le pire étant représenté par un nombre très
important de lignes traitées au début, pour aboutir à un petit nombre en fin de plan.
Visuellement, les flèches sont très épaisses à droite, puis très fines à gauche.
Par exemple, que constatons-nous sur la figure 8.5 ? Comme nous avons forcé
l’utilisation d’un index inutile pour résoudre le filtre de la clause WHERE, SQL Server
est obligé de nous obéir : il parcourt le nœud feuille de l’index (index scan) pour en
extraire les ContactID contenus dans la clé de l’index (tous les index contiennent en
plus la clé de l’index clustered). Le résultat, 19 973 lignes sont retournées, pour un
total de 125 Ko, comme nous pouvons le voir sur la figure 8.6.
Figure 8.6 — Envoi d’un opérateur à l’autre