

242
Chapitre 8. Optimisation du code SQL
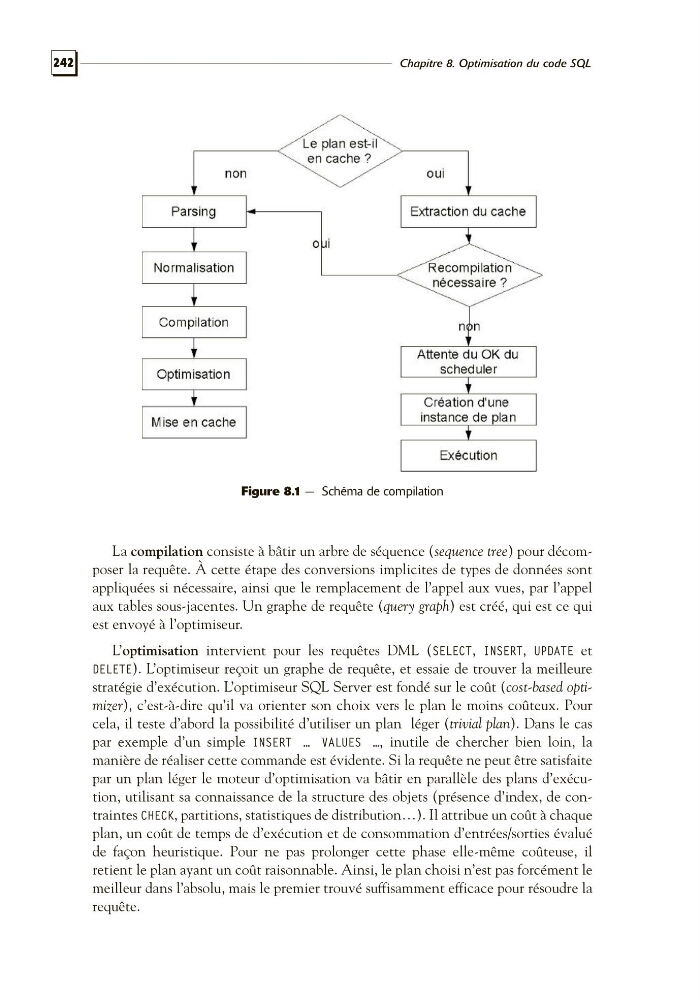
Figure 8.1 — Schéma de compilation
La compilation consiste à bâtir un arbre de séquence (sequence tree) pour décomposer la requête. À cette étape des conversions implicites de types de données sont
appliquées si nécessaire, ainsi que le remplacement de l’appel aux vues, par l’appel
aux tables sous-jacentes. Un graphe de requête (query graph) est créé, qui est ce qui
est envoyé à l’optimiseur.
L’optimisation intervient pour les requêtes DML (SELECT, INSERT, UPDATE et
DELETE). L’optimiseur reçoit un graphe de requête, et essaie de trouver la meilleure
stratégie d’exécution. L’optimiseur SQL Server est fondé sur le coût (cost-based optimizer), c’est-à-dire qu’il va orienter son choix vers le plan le moins coûteux. Pour
cela, il teste d’abord la possibilité d’utiliser un plan léger (trivial plan). Dans le cas
par exemple d’un simple INSERT … VALUES …, inutile de chercher bien loin, la
manière de réaliser cette commande est évidente. Si la requête ne peut être satisfaite
par un plan léger le moteur d’optimisation va bâtir en parallèle des plans d’exécution, utilisant sa connaissance de la structure des objets (présence d’index, de contraintes CHECK, partitions, statistiques de distribution…). Il attribue un coût à chaque
plan, un coût de temps de d’exécution et de consommation d’entrées/sorties évalué
de façon heuristique. Pour ne pas prolonger cette phase elle-même coûteuse, il
retient le plan ayant un coût raisonnable. Ainsi, le plan choisi n’est pas forcément le
meilleur dans l’absolu, mais le premier trouvé suffisamment efficace pour résoudre la
requête.