

158
Chapitre 6. Utilisation des index
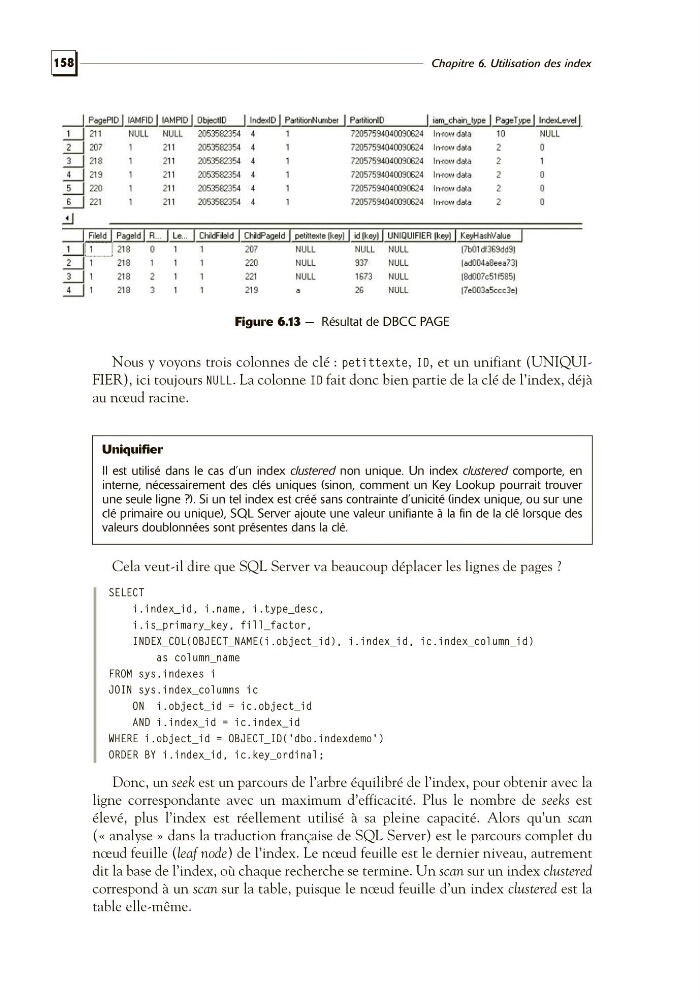
Figure 6.13 — Résultat de DBCC PAGE
Nous y voyons trois colonnes de clé : petittexte, ID, et un unifiant (UNIQUIFIER), ici toujours NULL. La colonne ID fait donc bien partie de la clé de l’index, déjà
au nœud racine.
Uniquifier
Il est utilisé dans le cas d’un index clustered non unique. Un index clustered comporte, en
interne, nécessairement des clés uniques (sinon, comment un Key Lookup pourrait trouver
une seule ligne ?). Si un tel index est créé sans contrainte d’unicité (index unique, ou sur une
clé primaire ou unique), SQL Server ajoute une valeur unifiante à la fin de la clé lorsque des
valeurs doublonnées sont présentes dans la clé.
Cela veut-il dire que SQL Server va beaucoup déplacer les lignes de pages ?
SELECT
i.index_id, i.name, i.type_desc,
i.is_primary_key, fill_factor,
INDEX_COL(OBJECT_NAME(i.object_id), i.index_id, ic.index_column_id)
as column_name
FROM sys.indexes i
JOIN sys.index_columns ic
ON i.object_id = ic.object_id
AND i.index_id = ic.index_id
WHERE i.object_id = OBJECT_ID('dbo.indexdemo')
ORDER BY i.index_id, ic.key_ordinal;
Donc, un seek est un parcours de l’arbre équilibré de l’index, pour obtenir avec la
ligne correspondante avec un maximum d’efficacité. Plus le nombre de seeks est
élevé, plus l’index est réellement utilisé à sa pleine capacité. Alors qu’un scan
(« analyse » dans la traduction française de SQL Server) est le parcours complet du
nœud feuille (leaf node) de l’index. Le nœud feuille est le dernier niveau, autrement
dit la base de l’index, où chaque recherche se termine. Un scan sur un index clustered
correspond à un scan sur la table, puisque le nœud feuille d’un index clustered est la
table elle-même.