

156
Chapitre 6. Utilisation des index
GO
CREATE NONCLUSTERED INDEX nix$dbo_indexdemo$petittexte 1
ON dbo.indexdemo (petittexte ASC);
GO
SELECT * FROM dbo.indexdemo WHERE petittexte = 'c';
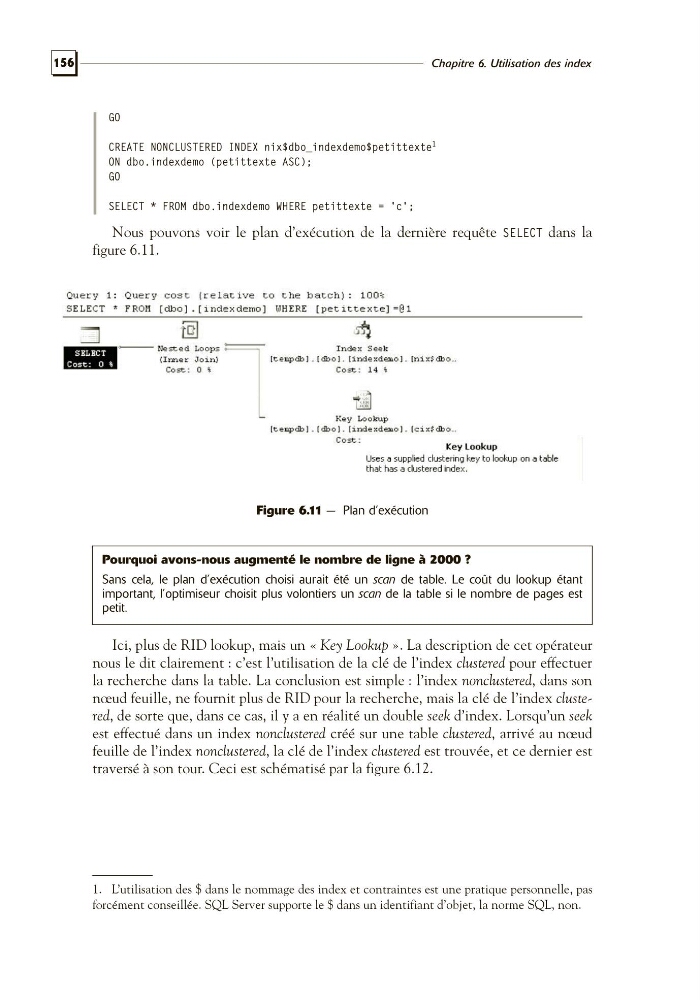
Nous pouvons voir le plan d’exécution de la dernière requête SELECT dans la
figure 6.11.
Figure 6.11 — Plan d’exécution
Pourquoi avons-nous augmenté le nombre de ligne à 2000 ?
Sans cela, le plan d’exécution choisi aurait été un scan de table. Le coût du lookup étant
important, l’optimiseur choisit plus volontiers un scan de la table si le nombre de pages est
petit.
Ici, plus de RID lookup, mais un « Key Lookup ». La description de cet opérateur
nous le dit clairement : c’est l’utilisation de la clé de l’index clustered pour effectuer
la recherche dans la table. La conclusion est simple : l’index nonclustered, dans son
nœud feuille, ne fournit plus de RID pour la recherche, mais la clé de l’index clustered, de sorte que, dans ce cas, il y a en réalité un double seek d’index. Lorsqu’un seek
est effectué dans un index nonclustered créé sur une table clustered, arrivé au nœud
feuille de l’index nonclustered, la clé de l’index clustered est trouvée, et ce dernier est
traversé à son tour. Ceci est schématisé par la figure 6.12.
1. L’utilisation des $ dans le nommage des index et contraintes est une pratique personnelle, pas
forcément conseillée. SQL Server supporte le $ dans un identifiant d’objet, la norme SQL, non.