

148
Chapitre 6. Utilisation des index
données qui contiennent la table sont chargées, ce qui peut signifier des gigaoctets
pour un simple SELECT… Ce parcours est appelé un scan.
Le seul moyen d’éviter cela, est de créer un index. Un index est proprement une
sorte de table des matières, contenant dans une structure arborescente toutes les
valeurs présentes dans une ou plusieurs colonnes, qui permet une recherche optimisée sur les valeurs qu’elle contient. Cet arbre est appelé arbre équilibré (balanced
tree, ou B-Tree).
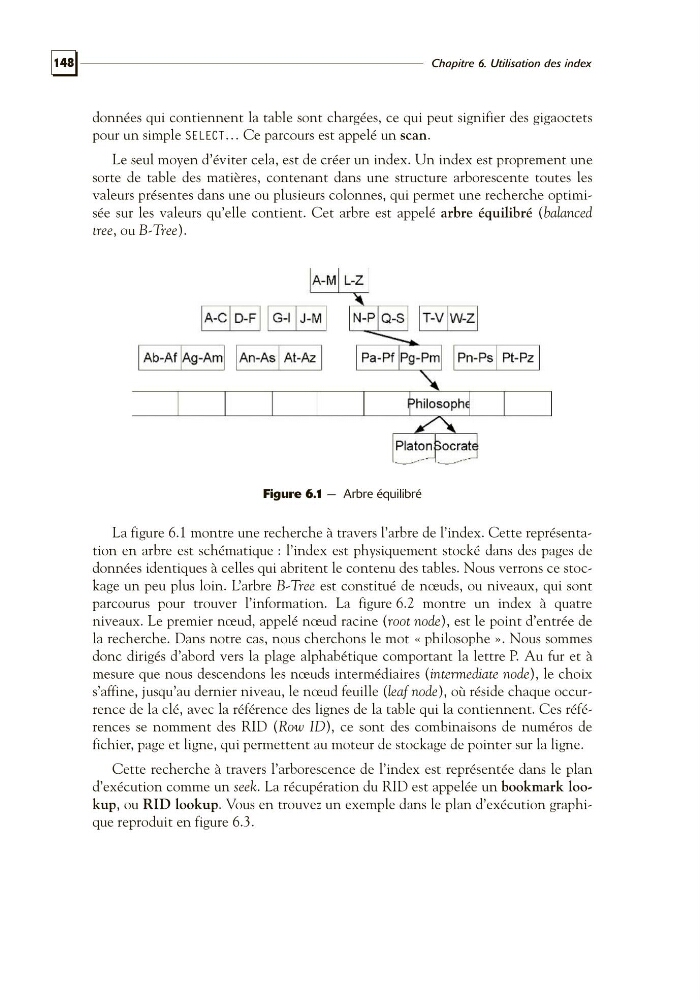
Figure 6.1 — Arbre équilibré
La figure 6.1 montre une recherche à travers l’arbre de l’index. Cette représentation en arbre est schématique : l’index est physiquement stocké dans des pages de
données identiques à celles qui abritent le contenu des tables. Nous verrons ce stockage un peu plus loin. L’arbre B-Tree est constitué de nœuds, ou niveaux, qui sont
parcourus pour trouver l’information. La figure 6.2 montre un index à quatre
niveaux. Le premier nœud, appelé nœud racine (root node), est le point d’entrée de
la recherche. Dans notre cas, nous cherchons le mot « philosophe ». Nous sommes
donc dirigés d’abord vers la plage alphabétique comportant la lettre P. Au fur et à
mesure que nous descendons les nœuds intermédiaires (intermediate node), le choix
s’affine, jusqu’au dernier niveau, le nœud feuille (leaf node), où réside chaque occurrence de la clé, avec la référence des lignes de la table qui la contiennent. Ces références se nomment des RID (Row ID), ce sont des combinaisons de numéros de
fichier, page et ligne, qui permettent au moteur de stockage de pointer sur la ligne.
Cette recherche à travers l’arborescence de l’index est représentée dans le plan
d’exécution comme un seek. La récupération du RID est appelée un bookmark lookup, ou RID lookup. Vous en trouvez un exemple dans le plan d’exécution graphique reproduit en figure 6.3.