

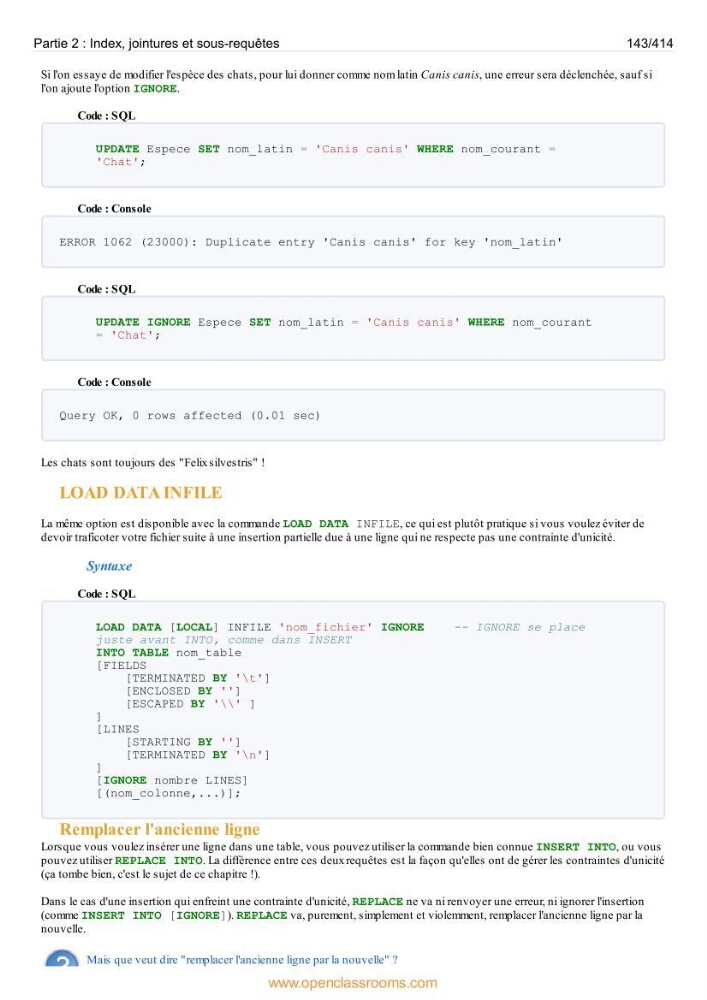
Si l'on essaye de modifier l'espèce des chats, pour lui donner comme nom latin Canis canis, une erreur sera déclenchée, sauf si
l'on ajoute l'option IGNORE.
Code : SQL
UPDATE Espece SET nom_latin = 'Canis canis' WHERE nom_courant =
'Chat';
Code : Console
ERROR 1062 (23000): Duplicate entry 'Canis canis' for key 'nom_latin'
Code : SQL
UPDATE IGNORE Espece SET nom_latin = 'Canis canis' WHERE nom_courant
= 'Chat';
Code : Console
Query OK, 0 rows affected (0.01 sec)
Les chats sont toujours des "Felix silvestris" !
LOAD DATA INFILE
La même option est disponible avec la commande LOAD DATA INFILE, ce qui est plutôt pratique si vous voulez éviter de
devoir traficoter votre fichier suite à une insertion partielle due à une ligne qui ne respecte pas une contrainte d'unicité.
Syntaxe
Code : SQL
LOAD DATA [LOCAL] INFILE 'nom_fichier' IGNORE
-- IGNORE se place
juste avant INTO, comme dans INSERT
INTO TABLE nom_table
[FIELDS
[TERMINATED BY '\t']
[ENCLOSED BY '']
[ESCAPED BY '\\' ]
]
[LINES
[STARTING BY '']
[TERMINATED BY '\n']
]
[IGNORE nombre LINES]
[(nom_colonne,...)];
Remplacer l'ancienne ligne
Lorsque vous voulez insérer une ligne dans une table, vous pouvez utiliser la commande bien connue INSERT INTO, ou vous
pouvez utiliser REPLACE INTO. La différence entre ces deux requêtes est la façon qu'elles ont de gérer les contraintes d'unicité
(ça tombe bien, c'est le sujet de ce chapitre !).
Dans le cas d'une insertion qui enfreint une contrainte d'unicité, REPLACE ne va ni renvoyer une erreur, ni ignorer l'insertion
(comme INSERT INTO [IGNORE]). REPLACE va, purement, simplement et violemment, remplacer l'ancienne ligne par la
nouvelle.
Mais que veut dire "remplacer l'ancienne ligne par la nouvelle" ?
Partie 2 : Index, jointures et sous-requêtes
143/414
www.openclassrooms.com