

1. Conception de la base de données
La première chose à faire quand on veut créer une base de données relationnelle est de
définir les tables, leurs attributs et leurs relations. Pour les besoins de BiblioApp, nous
pourrions nous contenter d'une seule table Livres, très similaire au fichier JSON
utilisé jusqu'ici. Toutefois, comme évoqué dans l'introduction, un des intérêts des bases
de données relationnelles est de pouvoir éviter les redondances : dans notre cas, il
s'agit des attributs auteur, éditeur et genre. Pour la facilité, nous nous limiterons ici
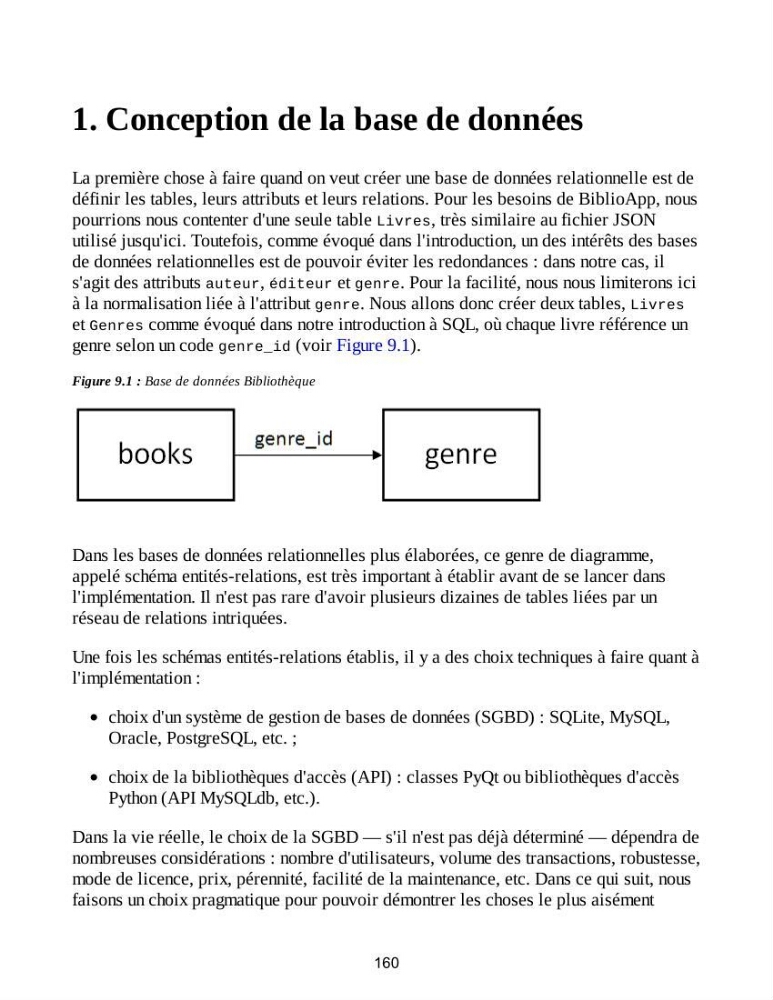
à la normalisation liée à l'attribut genre. Nous allons donc créer deux tables, Livres
et Genres comme évoqué dans notre introduction à SQL, où chaque livre référence un
genre selon un code genre_id (voir Figure 9.1).
Figure 9.1 : Base de données Bibliothèque
Dans les bases de données relationnelles plus élaborées, ce genre de diagramme,
appelé schéma entités-relations, est très important à établir avant de se lancer dans
l'implémentation. Il n'est pas rare d'avoir plusieurs dizaines de tables liées par un
réseau de relations intriquées.
Une fois les schémas entités-relations établis, il y a des choix techniques à faire quant à
l'implémentation :
choix d'un système de gestion de bases de données (SGBD) : SQLite, MySQL,
Oracle, PostgreSQL, etc. ;
choix de la bibliothèques d'accès (API) : classes PyQt ou bibliothèques d'accès
Python (API MySQLdb, etc.).
Dans la vie réelle, le choix de la SGBD — s'il n'est pas déjà déterminé — dépendra de
nombreuses considérations : nombre d'utilisateurs, volume des transactions, robustesse,
mode de licence, prix, pérennité, facilité de la maintenance, etc. Dans ce qui suit, nous
faisons un choix pragmatique pour pouvoir démontrer les choses le plus aisément
160