

4.3 M´ ethodes it´ eratives stationnaires et instationnaires
145
Th´ eor` eme 4.11 Soit A une matrice sym´ etrique d´ efinie positive d’ordre n.
Toute m´ ethode qui utilise des directions conjugu´ ees pour r´ esoudre (3.2) conduit
` a la solution exacte en au plus n it´ erations.
D´ emonstration. Les directions p
(0) , p
(1) , . . . , p
(n−1) forment une base A-orthogonale de R
n . De plus, puisque x
(k) est optimal par rapport `
a toutes les directions
p
(j) , j = 0, . . . , k − 1, le vecteur r
(k) est orthogonal `
a l’espace Vk−1 = vect(p
(0) , p
(1) ,
. . . , p
(k−1) ). Par cons´ equent, r
(n) ⊥ Vn−1 = R
n et donc r
(n) = 0 ce qui implique
x
(n) = x.
3
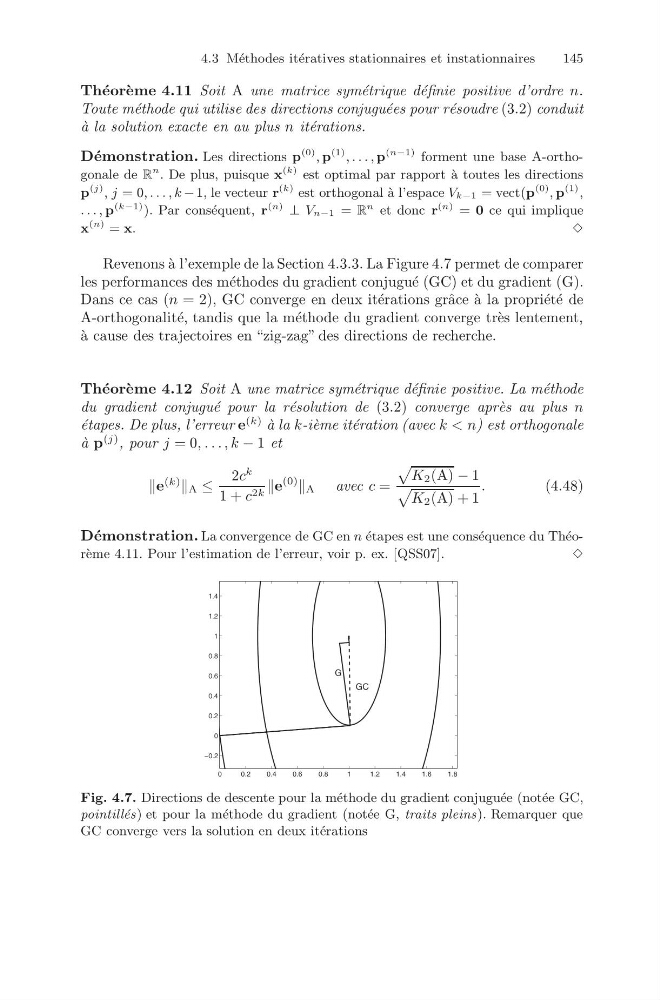
Revenons ` a l’exemple de la Section 4.3.3. La Figure 4.7 permet de comparer
les performances des m´ ethodes du gradient conjugu´ e (GC) et du gradient (G).
Dans ce cas (n = 2), GC converge en deux it´ erations grˆ ace ` a la propri´ et´ e de
A-orthogonalit´ e, tandis que la m´ ethode du gradient converge tr` es lentement,
` a cause des trajectoires en “zig-zag” des directions de recherche.
Th´ eor` eme 4.12 Soit A une matrice sym´ etrique d´ efinie positive. La m´ ethode
du gradient conjugu´ e pour la r´ esolution de (3.2) converge apr` es au plus n
´ etapes. De plus, l’erreur e
(k) ` a la k-i` eme it´ eration (avec k < n) est orthogonale
` a p
(j) , pour j = 0, . . . , k − 1 et
(k)
A ≤
2c
k
1 + c 2k e
(0)
A avec c =
K 2 (A) − 1
K 2 (A) + 1
.
(4.48)
D´ emonstration. La convergence de GC en n ´ etapes est une cons´ equence du Th´ eor` eme 4.11. Pour l’estimation de l’erreur, voir p. ex. [QSS07].
3
0
0.2
0.4
0.6
0.8
1
1.2
1.4
1.6
1.8
−0.2
0
0.2
0.4
0.6
0.8
1
1.2
1.4
GC
G
Fig. 4.7. Directions de descente pour la m´ ethode du gradient conjugu´ ee (not´ ee GC,
pointill´ es) et pour la m´ ethode du gradient (not´ ee G, traits pleins). Remarquer que
GC converge vers la solution en deux it´ erations