

4.3 M´ ethodes it´ eratives stationnaires et instationnaires
139
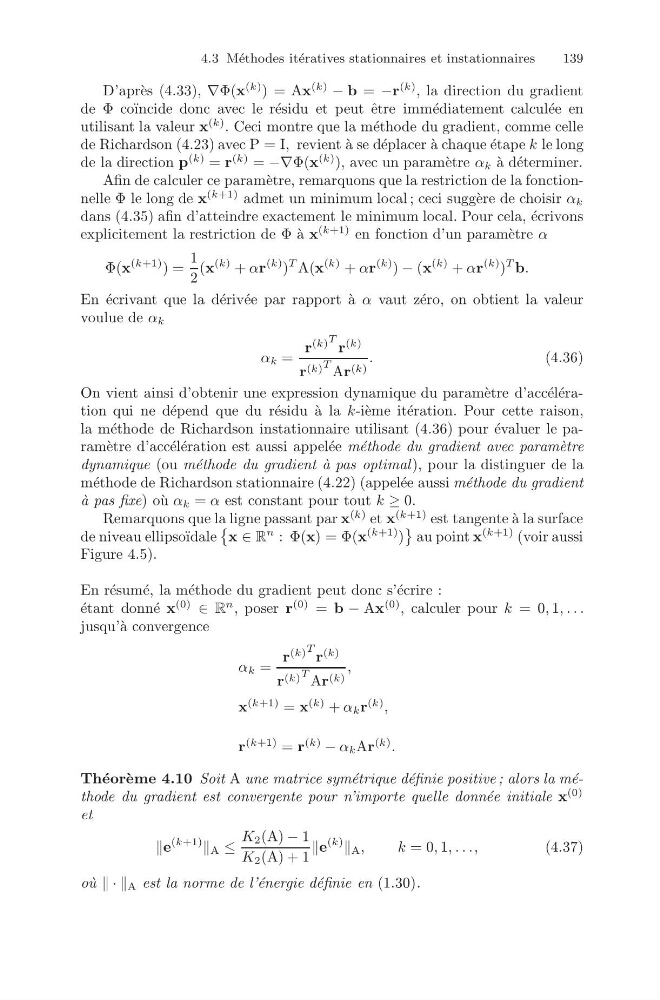
D’apr` es (4.33), ∇Φ(x
(k) ) = Ax
(k)
− b = −r
(k) , la direction du gradient
de Φ co¨ ıncide donc avec le r´ esidu et peut ˆ etre imm´ ediatement calcul´ ee en
utilisant la valeur x
(k) . Ceci montre que la m´ ethode du gradient, comme celle
de Richardson (4.23) avec P = I, revient `
a se d´ eplacer ` a chaque ´ etape k le long
de la direction p
(k) = r
(k) = −∇Φ(x
(k) ), avec un param` etre α k ` a d´ eterminer.
Afin de calculer ce param` etre, remarquons que la restriction de la fonctionnelle Φ le long de x
(k+1) admet un minimum local ; ceci sugg` ere de choisir α k
dans (4.35) afin d’atteindre exactement le minimum local. Pour cela, ´ ecrivons
explicitement la restriction de Φ `
a x
(k+1) en fonction d’un param` etre α
Φ(x
(k+1) ) =
1
2
(x
(k) + αr
(k) )
T A(x
(k) + αr
(k) ) − (x
(k) + αr
(k) )
T b.
En ´ ecrivant que la d´ eriv´ ee par rapport `
a α vaut z´ ero, on obtient la valeur
voulue de α k
α k =
r
(k) T r
(k)
r (k) T Ar (k)
.
(4.36)
On vient ainsi d’obtenir une expression dynamique du param` etre d’acc´ el´ eration qui ne d´ epend que du r´ esidu `
a la k-i` eme it´ eration. Pour cette raison,
la m´ ethode de Richardson instationnaire utilisant (4.36) pour ´ evaluer le param` etre d’acc´ el´ eration est aussi appel´ ee m´ ethode du gradient avec param` etre
dynamique (ou m´ ethode du gradient `
a pas optimal ), pour la distinguer de la
m´ ethode de Richardson stationnaire (4.22) (appel´ ee aussi m´ ethode du gradient
` a pas fixe) o` u α k = α est constant pour tout k ≥ 0.
Remarquons que la ligne passant par x
(k) et x
(k+1) est tangente ` a la surface
de niveau ellipso¨ ıdale
x ∈ R
n : Φ(x) = Φ(x
(k+1) )
au point x
(k+1) (voir aussi
Figure 4.5).
En r´ esum´ e, la m´ ethode du gradient peut donc s’´ ecrire :
´ etant donn´ e x
(0)
∈ R
n , poser r
(0) = b − Ax
(0) , calculer pour k = 0, 1, . . .
jusqu’` a convergence
α k =
r
(k) T r
(k)
r (k) T Ar (k)
,
x
(k+1) = x
(k) + α k r
(k) ,
r
(k+1) = r
(k)
− α k Ar
(k) .
Th´ eor` eme 4.10 Soit A une matrice sym´ etrique d´ efinie positive ; alors la m´ ethode du gradient est convergente pour n’importe quelle donn´ ee initiale x
(0)
et
(k+1)
A ≤
K 2 (A) − 1
K 2 (A) + 1
(k)
A ,
k = 0, 1, . . .,
(4.37)
o` u · · A est la norme de l’´ energie d´ efinie en (1.30).