

xvi
Introduction
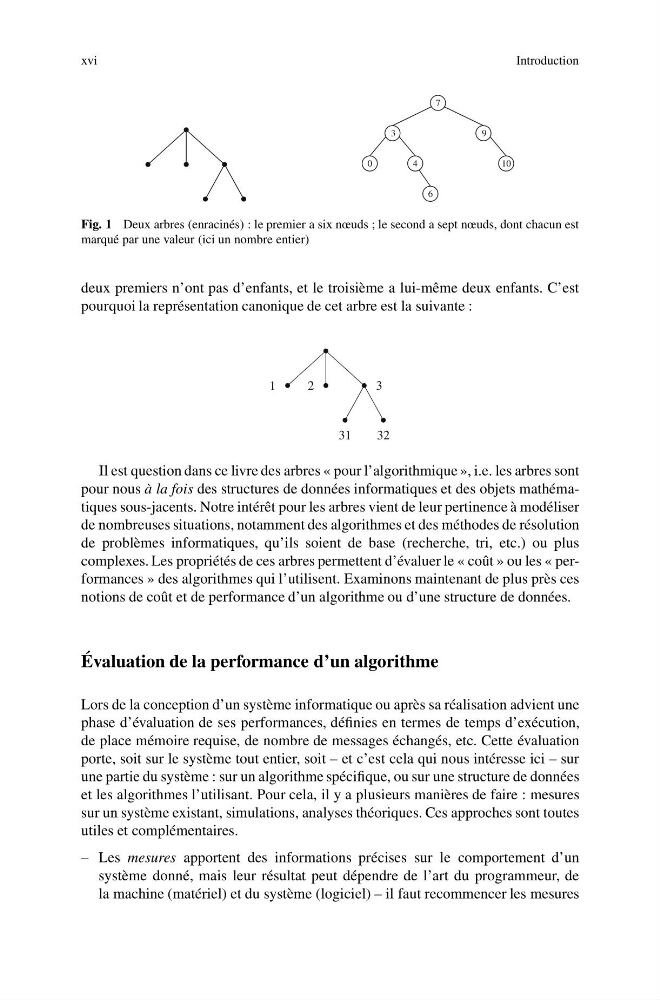
Fig. 1 Deux arbres (enracinés) : le premier a six nœuds ; le second a sept nœuds, dont chacun est
marqué par une valeur (ici un nombre entier)
deux premiers n’ont pas d’enfants, et le troisième a lui-même deux enfants. C’est
pourquoi la représentation canonique de cet arbre est la suivante :
Il est question dans ce livre des arbres « pour l’algorithmique », i.e. les arbres sont
pour nous à la fois des structures de données informatiques et des objets mathématiques sous-jacents. Notre intérêt pour les arbres vient de leur pertinence à modéliser
de nombreuses situations, notamment des algorithmes et des méthodes de résolution
de problèmes informatiques, qu’ils soient de base (recherche, tri, etc.) ou plus
complexes. Les propriétés de ces arbres permettent d’évaluer le « coût » ou les « performances » des algorithmes qui l’utilisent. Examinons maintenant de plus près ces
notions de coût et de performance d’un algorithme ou d’une structure de données.
Évaluation de la performance d’un algorithme
Lors de la conception d’un système informatique ou après sa réalisation advient une
phase d’évaluation de ses performances, définies en termes de temps d’exécution,
de place mémoire requise, de nombre de messages échangés, etc. Cette évaluation
porte, soit sur le système tout entier, soit – et c’est cela qui nous intéresse ici – sur
une partie du système : sur un algorithme spécifique, ou sur une structure de données
et les algorithmes l’utilisant. Pour cela, il y a plusieurs manières de faire : mesures
sur un système existant, simulations, analyses théoriques. Ces approches sont toutes
utiles et complémentaires.
– Les mesures apportent des informations précises sur le comportement d’un
système donné, mais leur résultat peut dépendre de l’art du programmeur, de
la machine (matériel) et du système (logiciel) – il faut recommencer les mesures