

110
3 Arbres, algorithmes et données
Regardons un exemple : prenons un nombre de places dans la mémoire de travail
(peu réaliste !) m = 2, et des clés x 1 = 10011 . . . , x 2 = 01100 . . . , x 3 =
10001 . . . , x 4 = 11001 . . . , x 5 = 00100 . . . , x 6 = 10110 . . . , x 7 = 00111 . . .
arrivant dans cet ordre. Au départ, δ = ν = 0. Les deux premières clés vont dans la
mémoire de travail ; à ce moment ν = 2 et δ = 0. À l’arrivée de x 3 , l’algorithme
ne garde en mémoire que la clé x 2 , ν repasse à 1 et δ prend la valeur 1. Lorsque
la clé x 4 arrive, l’algorithme ne la retient pas : à ce stade, il ne retient que les clés
commençant par 0. Puis la clé x 5 est gardée en mémoire, et ν passe à 2. La clé x 6 ,
commençant par 1, n’est pas gardée. Enfin la clé x 7 arrive, et devrait aller dans la
mémoire de travail qui est déjà pleine : cela provoque donc l’augmentation de δ
qui passe à 2, l’élimination de x 2 qui commence par 01, et la mémoire de travail
contient maintenant les deux clés x 5 et x 7 qui commencent toutes deux par 00. À ce
point de l’algorithme, l’évaluation du nombre de clés que l’algorithme a vu passer
est
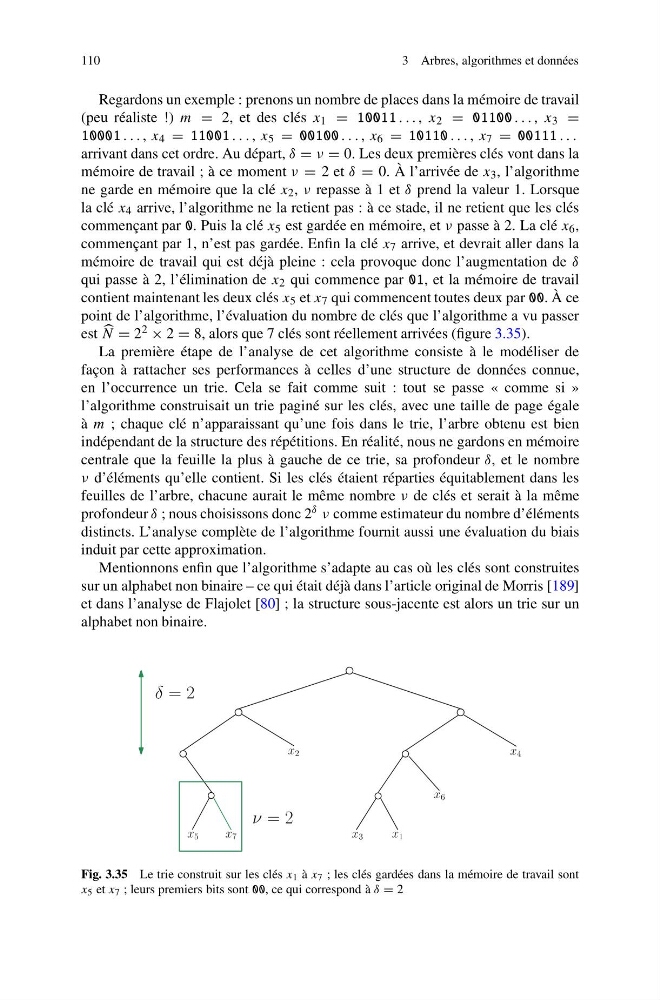
N = 2 2 × 2 = 8, alors que 7 clés sont réellement arrivées (figure 3.35).
La première étape de l’analyse de cet algorithme consiste à le modéliser de
façon à rattacher ses performances à celles d’une structure de données connue,
en l’occurrence un trie. Cela se fait comme suit : tout se passe « comme si »
l’algorithme construisait un trie paginé sur les clés, avec une taille de page égale
à m ; chaque clé n’apparaissant qu’une fois dans le trie, l’arbre obtenu est bien
indépendant de la structure des répétitions. En réalité, nous ne gardons en mémoire
centrale que la feuille la plus à gauche de ce trie, sa profondeur δ, et le nombre
ν d’éléments qu’elle contient. Si les clés étaient réparties équitablement dans les
feuilles de l’arbre, chacune aurait le même nombre ν de clés et serait à la même
profondeur δ ; nous choisissons donc 2 δ ν comme estimateur du nombre d’éléments
distincts. L’analyse complète de l’algorithme fournit aussi une évaluation du biais
induit par cette approximation.
Mentionnons enfin que l’algorithme s’adapte au cas où les clés sont construites
sur un alphabet non binaire – ce qui était déjà dans l’article original de Morris [189]
et dans l’analyse de Flajolet [80] ; la structure sous-jacente est alors un trie sur un
alphabet non binaire.
Fig. 3.35 Le trie construit sur les clés x 1 à x 7 ; les clés gardées dans la mémoire de travail sont
x 5 et x 7 ; leurs premiers bits sont 00, ce qui correspond à δ = 2