

3.2 Recherche de clés
77
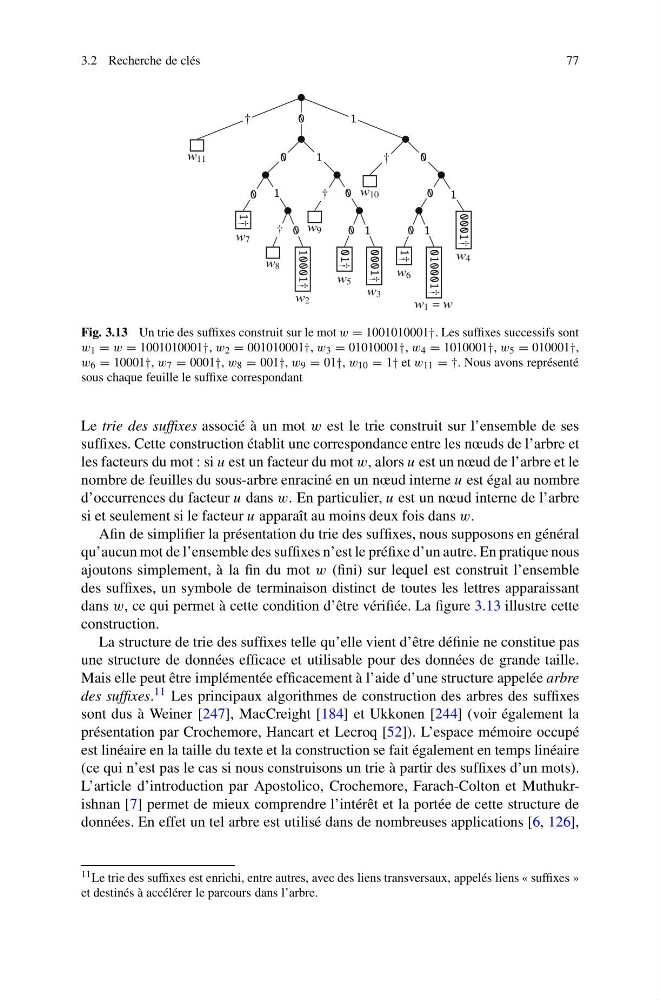
Fig. 3.13 Un trie des suffixes construit sur le mot w = 1001010001†. Les suffixes successifs sont
w 1 = w = 1001010001†, w 2 = 001010001†, w 3 = 01010001†, w 4 = 1010001†, w 5 = 010001†,
w 6 = 10001†, w 7 = 0001†, w 8 = 001†, w 9 = 01†, w 10 = 1† et w 11 = †. Nous avons représenté
sous chaque feuille le suffixe correspondant
Le trie des suffixes associé à un mot w est le trie construit sur l’ensemble de ses
suffixes. Cette construction établit une correspondance entre les nœuds de l’arbre et
les facteurs du mot : si u est un facteur du mot w, alors u est un nœud de l’arbre et le
nombre de feuilles du sous-arbre enraciné en un nœud interne u est égal au nombre
d’occurrences du facteur u dans w. En particulier, u est un nœud interne de l’arbre
si et seulement si le facteur u apparaît au moins deux fois dans w.
Afin de simplifier la présentation du trie des suffixes, nous supposons en général
qu’aucun mot de l’ensemble des suffixes n’est le préfixe d’un autre. En pratique nous
ajoutons simplement, à la fin du mot w (fini) sur lequel est construit l’ensemble
des suffixes, un symbole de terminaison distinct de toutes les lettres apparaissant
dans w, ce qui permet à cette condition d’être vérifiée. La figure 3.13 illustre cette
construction.
La structure de trie des suffixes telle qu’elle vient d’être définie ne constitue pas
une structure de données efficace et utilisable pour des données de grande taille.
Mais elle peut être implémentée efficacement à l’aide d’une structure appelée arbre
des suffixes. 11 Les principaux algorithmes de construction des arbres des suffixes
sont dus à Weiner [247], MacCreight [184] et Ukkonen [244] (voir également la
présentation par Crochemore, Hancart et Lecroq [52]). L’espace mémoire occupé
est linéaire en la taille du texte et la construction se fait également en temps linéaire
(ce qui n’est pas le cas si nous construisons un trie à partir des suffixes d’un mots).
L’article d’introduction par Apostolico, Crochemore, Farach-Colton et Muthukrishnan [7] permet de mieux comprendre l’intérêt et la portée de cette structure de
données. En effet un tel arbre est utilisé dans de nombreuses applications [6, 126],
11 Le trie des suffixes est enrichi, entre autres, avec des liens transversaux, appelés liens « suffixes »
et destinés à accélérer le parcours dans l’arbre.