

7.1 High-Level-Optimierungen
383
explizite Benutzung dieser Variablen dem Compiler hilft, hier ein Register zuzuweisen. Wir nehmen an, dass die Elemente des Feldes in row-major order angeordnet sind (wie es in C Standard ist). Damit werden Feldelemente mit benachbarten
(rechten) Reihenindizes in benachbarten Speicherstellen abgelegt. Also werden die
benachbarten Stellen von X während der Iterationen der innersten Schleife geladen.
Diese Eigenschaft ist von Vorteil, wenn das Speichersystem Prefetching verwendet
(jedes Mal, wenn ein Wort in den Cache geladen wird, wird auch das Laden des
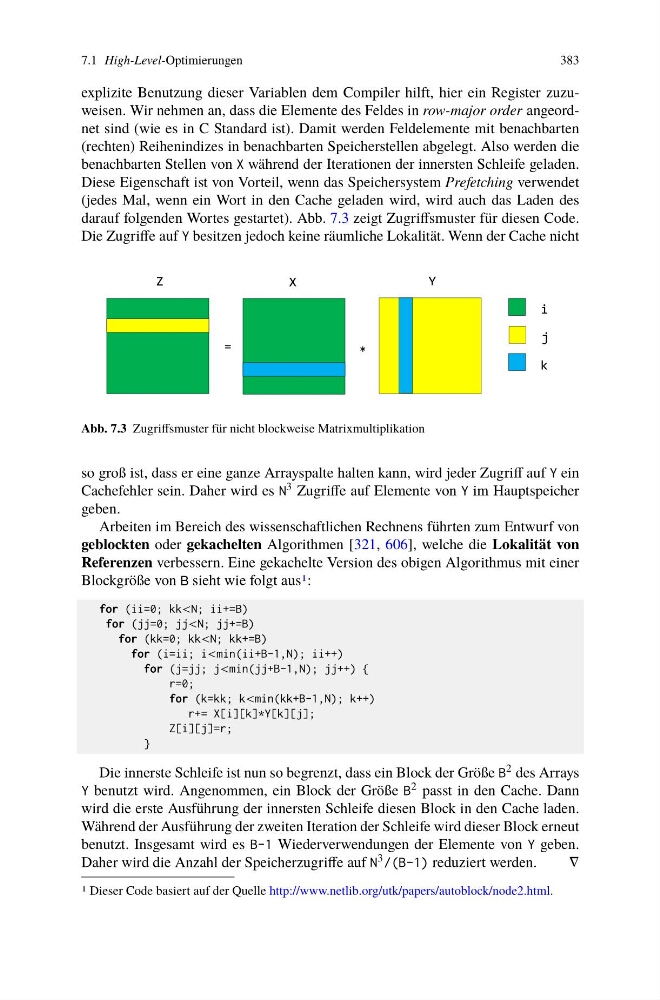
darauf folgenden Wortes gestartet). Abb. 7.3 zeigt Zugriffsmuster für diesen Code.
Die Zugriffe auf Y besitzen jedoch keine räumliche Lokalität. Wenn der Cache nicht
Z
=
*
X
Y
i
j
k
Abb. 7.3 Zugriffsmuster für nicht blockweise Matrixmultiplikation
so groß ist, dass er eine ganze Arrayspalte halten kann, wird jeder Zugriff auf Y ein
Cachefehler sein. Daher wird es N 3 Zugriffe auf Elemente von Y im Hauptspeicher
geben.
Arbeiten im Bereich des wissenschaftlichen Rechnens führten zum Entwurf von
geblockten oder gekachelten Algorithmen [321, 606], welche die Lokalität von
Referenzen verbessern. Eine gekachelte Version des obigen Algorithmus mit einer
Blockgröße von B sieht wie folgt aus1:
for (ii=0; kk
for (jj=0; jj
for (kk=0; kk
for (i=ii; i
for (k=kk; k
Z[i][j]=r;
}
Die innerste Schleife ist nun so begrenzt, dass ein Block der Größe B 2 des Arrays
Y benutzt wird. Angenommen, ein Block der Größe B 2 passt in den Cache. Dann
wird die erste Ausführung der innersten Schleife diesen Block in den Cache laden.
Während der Ausführung der zweiten Iteration der Schleife wird dieser Block erneut
benutzt. Insgesamt wird es B-1 Wiederverwendungen der Elemente von Y geben.
Daher wird die Anzahl der Speicherzugriffe auf N 3 /(B-1) reduziert werden.
∇
1 Dieser Code basiert auf der Quelle http://www.netlib.org/utk/papers/autoblock/node2.html.
383
explizite Benutzung dieser Variablen dem Compiler hilft, hier ein Register zuzuweisen. Wir nehmen an, dass die Elemente des Feldes in row-major order angeordnet sind (wie es in C Standard ist). Damit werden Feldelemente mit benachbarten
(rechten) Reihenindizes in benachbarten Speicherstellen abgelegt. Also werden die
benachbarten Stellen von X während der Iterationen der innersten Schleife geladen.
Diese Eigenschaft ist von Vorteil, wenn das Speichersystem Prefetching verwendet
(jedes Mal, wenn ein Wort in den Cache geladen wird, wird auch das Laden des
darauf folgenden Wortes gestartet). Abb. 7.3 zeigt Zugriffsmuster für diesen Code.
Die Zugriffe auf Y besitzen jedoch keine räumliche Lokalität. Wenn der Cache nicht
Z
=
*
X
Y
i
j
k
Abb. 7.3 Zugriffsmuster für nicht blockweise Matrixmultiplikation
so groß ist, dass er eine ganze Arrayspalte halten kann, wird jeder Zugriff auf Y ein
Cachefehler sein. Daher wird es N 3 Zugriffe auf Elemente von Y im Hauptspeicher
geben.
Arbeiten im Bereich des wissenschaftlichen Rechnens führten zum Entwurf von
geblockten oder gekachelten Algorithmen [321, 606], welche die Lokalität von
Referenzen verbessern. Eine gekachelte Version des obigen Algorithmus mit einer
Blockgröße von B sieht wie folgt aus1:
for (ii=0; kk
for (k=kk; k
Z[i][j]=r;
}
Die innerste Schleife ist nun so begrenzt, dass ein Block der Größe B 2 des Arrays
Y benutzt wird. Angenommen, ein Block der Größe B 2 passt in den Cache. Dann
wird die erste Ausführung der innersten Schleife diesen Block in den Cache laden.
Während der Ausführung der zweiten Iteration der Schleife wird dieser Block erneut
benutzt. Insgesamt wird es B-1 Wiederverwendungen der Elemente von Y geben.
Daher wird die Anzahl der Speicherzugriffe auf N 3 /(B-1) reduziert werden.
∇
1 Dieser Code basiert auf der Quelle http://www.netlib.org/utk/papers/autoblock/node2.html.