

6.5 Abhängige Jobs auf heterogenen Multiprozessoren
367
s e (τ j , π l ) und f e (τ j , π l ) können aus einem partiellen Schedule iterativ wie folgt
berechnet werden:
s e (τ j , π l ) = max
avail(l), max τ i ∈pr ed(τ j ) ( f (τ i ) + h i, j,k,l )
(6.47)
f e (τ j , π l ) = c j,l + s e (τ j , π l )
(6.48)
wobei pred(τ j ) die Menge der unmittelbaren Vorgänger-Tasks von Task τ j ist,
k ist der Prozessor, auf den Task τ i im partiellen Schedule abgebildet ist und
avail(l) ist die Zeit, zu der Prozessor π l die Ausführung der letzten Task beendet
hat. Der max-Ausdruck im inneren Term bestimmt die Zeit, zu der alle Daten,
die von τ j benötigt werden, beim Prozessor π l angekommen sind.
• Als Zielkriterium nehmen wir den Makespan. Dieser wird aus dem Abschluss
der Berechnungen auf dem exit-Knoten bestimmt:
MS max = f (τ exit )
(6.49)
• Die durchschnittliche Ausführungszeit c i ist das Mittel der Ausführungszeiten
c i,k über alle Prozessoren k.
• Der Aufwärts-Rang (engl. upward rank) rank u (τ i ) einer Task τ i ist die Länge des
kritischen Pfades vom exit-Knoten bis zum Knoten τ i (diesen einschließend):
rank u (τ exit ) = c exit
(6.50)
rank u (τ i ) = c i + max
τ j ∈succ(τ i )
(h i, j + rank u (τ j ))
(6.51)
Dabei ist succ(τ i ) die Menge unmittelbaren Nachfolger von τ i im Task-Graphen.
• Der Abwärts-Rang (engl. downward rank) rank d (τ j ) ist die Länge des kritischen
Pfades vom start-Knoten bis zum Task-Knoten τ j (ohne τ j selbst):
rank d (τ entr y ) = 0
(6.52)
rank d (τ j ) = max
τ i ∈pr ed(τ j )
(rank d (τ i ) + c i + h i, j )
(6.53)
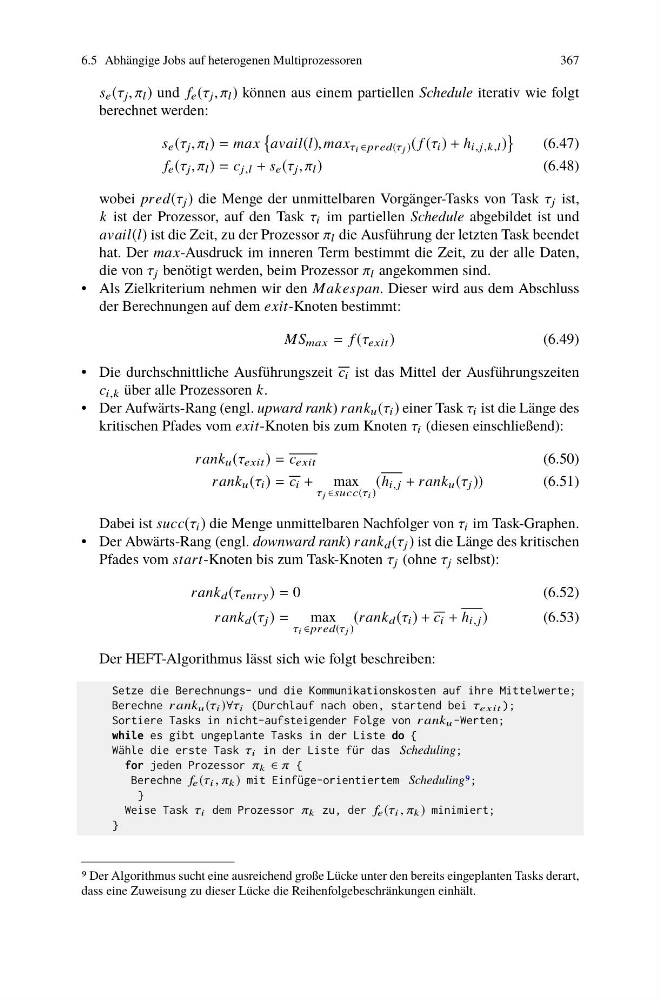
Der HEFT-Algorithmus lässt sich wie folgt beschreiben:
Setze die Berechnungs- und die Kommunikationskosten auf ihre Mitteewerte;
Berechne r ank u (τ i )∀τ i (Durchhauf nach oben, startend bei τ e x i t );
Sortiere Tasks in nicht-aufsteigender Fooge von r ank u -Werten;
whiie es gibt ungeppante Tasks in der Liste do {
Wähhe die erste Task τ i in der Liste für das Scheduling;
for jeden Prozessor π k ∈ π {
Berechne f e (τ i , π k ) mit Einfüge-orientiertem Scheduling9;
}
Weise Task τ i dem Prozessor π k zu, der f e (τ i , π k ) minimiert;
}
9 Der Algorithmus sucht eine ausreichend große Lücke unter den bereits eingeplanten Tasks derart,
dass eine Zuweisung zu dieser Lücke die Reihenfolgebeschränkungen einhält.