

3.3 Verarbeitungseinheiten
173
sich gezeigt, dass man beim Versuch einer weiteren Performanzsteigerung gegen die
sogenannte power wall läuft: über Jahre wurden Taktfrequenzen zwecks Performanzsteigerung erhöht, aber eine weitere Steigerung würde in einer zu hohen Stromaufnahme und in zu heißen Schaltkreisen resultieren. Eine weitere Steigerung der Parallelität in VLIW-Prozessoren war ebenfalls nicht möglich. Aufgrund der Fortschritte
in der Halbleiterfertigungstechnik ist es mittlerweile machbar, mehrere Prozessoren auf demselben Halbleiterchip zu fertigen. Wenn man mehrere Prozessoren auf
demselben Chip fertigt, so nennt man die Prozessoren Mehrkern-Prozessoren. Von
diesen unterscheiden muss man Multiprozessor-Systeme, wie sie in Rechenzentren
seit Jahrzehnten im Einsatz sind. Verglichen mit diesen erlaubt die Integration von
mehreren Kernen auf demselben Chip eine viel schnellere Kommunikation und eine
gemeinsame Nutzung von Ressourcen (wie z.B. Caches).
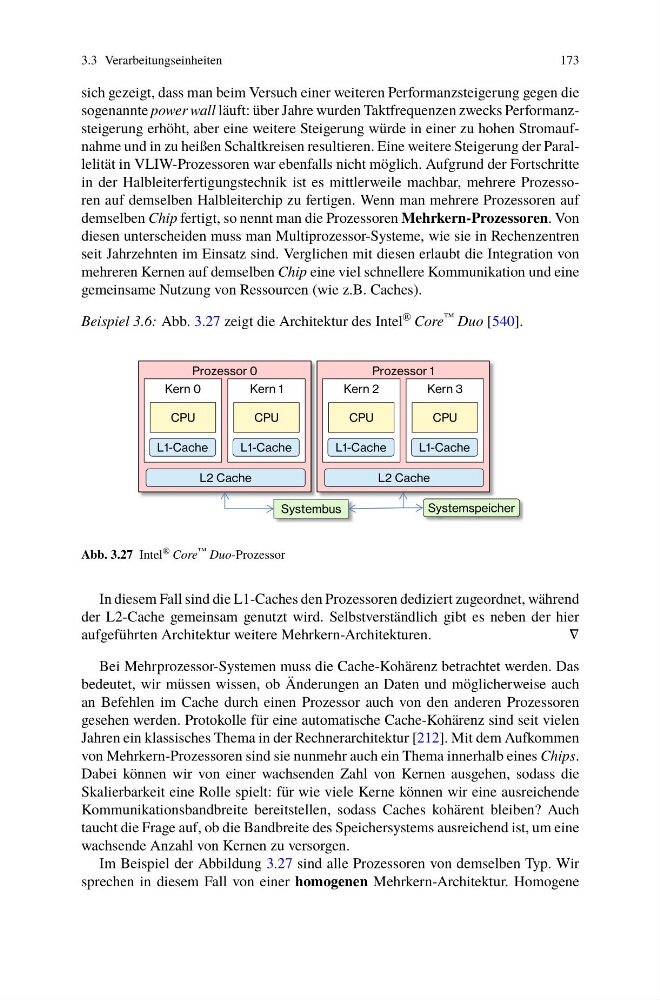
Beispiel 3.6: Abb. 3.27 zeigt die Architektur des Intel ® Core ™ Duo [540].
Prozessor 0
Kern 0
CPU
Systembus
L1-Cache
Kern 1
CPU
L1-Cache
L2 Cache
Prozessor 1
Kern 2
CPU
L1-Cache
Kern 3
CPU
L1-Cache
L2 Cache
Systemspeicher
Abb. 3.27 Intel ® Core ™ Duo-Prozessor
In diesem Fall sind die L1-Caches den Prozessoren dediziert zugeordnet, während
der L2-Cache gemeinsam genutzt wird. Selbstverständlich gibt es neben der hier
aufgeführten Architektur weitere Mehrkern-Architekturen.
∇
Bei Mehrprozessor-Systemen muss die Cache-Kohärenz betrachtet werden. Das
bedeutet, wir müssen wissen, ob Änderungen an Daten und möglicherweise auch
an Befehlen im Cache durch einen Prozessor auch von den anderen Prozessoren
gesehen werden. Protokolle für eine automatische Cache-Kohärenz sind seit vielen
Jahren ein klassisches Thema in der Rechnerarchitektur [212]. Mit dem Aufkommen
von Mehrkern-Prozessoren sind sie nunmehr auch ein Thema innerhalb eines Chips.
Dabei können wir von einer wachsenden Zahl von Kernen ausgehen, sodass die
Skalierbarkeit eine Rolle spielt: für wie viele Kerne können wir eine ausreichende
Kommunikationsbandbreite bereitstellen, sodass Caches kohärent bleiben? Auch
taucht die Frage auf, ob die Bandbreite des Speichersystems ausreichend ist, um eine
wachsende Anzahl von Kernen zu versorgen.
Im Beispiel der Abbildung 3.27 sind alle Prozessoren von demselben Typ. Wir
sprechen in diesem Fall von einer homogenen Mehrkern-Architektur. Homogene