

3.3 Verarbeitungseinheiten
171
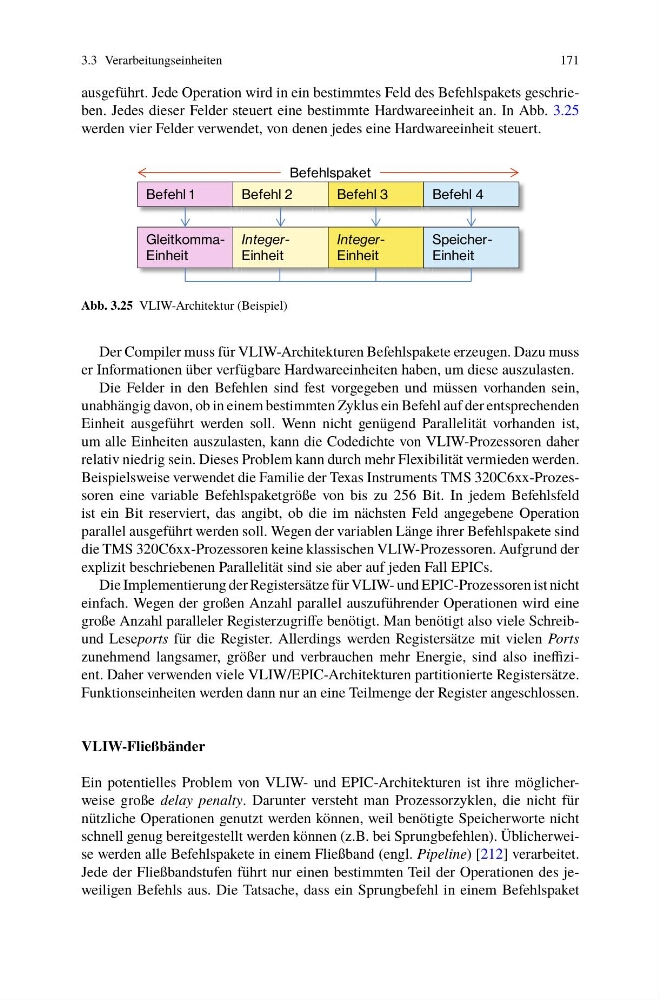
ausgeführt. Jede Operation wird in ein bestimmtes Feld des Befehlspakets geschrieben. Jedes dieser Felder steuert eine bestimmte Hardwareeinheit an. In Abb. 3.25
werden vier Felder verwendet, von denen jedes eine Hardwareeinheit steuert.
GleitkommaEinheit
Befehl 1
Befehlspaket
IntegerEinheit
Befehl 2
IntegerEinheit
Befehl 3
Befehl 4
SpeicherEinheit
Abb. 3.25 VLIW-Architektur (Beispiel)
Der Compiler muss für VLIW-Architekturen Befehlspakete erzeugen. Dazu muss
er Informationen über verfügbare Hardwareeinheiten haben, um diese auszulasten.
Die Felder in den Befehlen sind fest vorgegeben und müssen vorhanden sein,
unabhängig davon, ob in einem bestimmten Zyklus ein Befehl auf der entsprechenden
Einheit ausgeführt werden soll. Wenn nicht genügend Parallelität vorhanden ist,
um alle Einheiten auszulasten, kann die Codedichte von VLIW-Prozessoren daher
relativ niedrig sein. Dieses Problem kann durch mehr Flexibilität vermieden werden.
Beispielsweise verwendet die Familie der Texas Instruments TMS 320C6xx-Prozessoren eine variable Befehlspaketgröße von bis zu 256 Bit. In jedem Befehlsfeld
ist ein Bit reserviert, das angibt, ob die im nächsten Feld angegebene Operation
parallel ausgeführt werden soll. Wegen der variablen Länge ihrer Befehlspakete sind
die TMS 320C6xx-Prozessoren keine klassischen VLIW-Prozessoren. Aufgrund der
explizit beschriebenen Parallelität sind sie aber auf jeden Fall EPICs.
Die Implementierung der Registersätze für VLIW- und EPIC-Prozessoren ist nicht
einfach. Wegen der großen Anzahl parallel auszuführender Operationen wird eine
große Anzahl paralleler Registerzugriffe benötigt. Man benötigt also viele Schreibund Leseports für die Register. Allerdings werden Registersätze mit vielen Ports
zunehmend langsamer, größer und verbrauchen mehr Energie, sind also ineffizient. Daher verwenden viele VLIW/EPIC-Architekturen partitionierte Registersätze.
Funktionseinheiten werden dann nur an eine Teilmenge der Register angeschlossen.
VLIW-Fließbänder
Ein potentielles Problem von VLIW- und EPIC-Architekturen ist ihre möglicherweise große delay penalty. Darunter versteht man Prozessorzyklen, die nicht für
nützliche Operationen genutzt werden können, weil benötigte Speicherworte nicht
schnell genug bereitgestellt werden können (z.B. bei Sprungbefehlen). Üblicherweise werden alle Befehlspakete in einem Fließband (engl. Pipeline) [212] verarbeitet.
Jede der Fließbandstufen führt nur einen bestimmten Teil der Operationen des jeweiligen Befehls aus. Die Tatsache, dass ein Sprungbefehl in einem Befehlspaket