

94
M. Nakao and H. Murai
1 int me = xmpc_node_num();
2 int target = (me == 0)? 1 : 0;
3 ...
4 if(me == 0){
5
dst_buf[0:size]:[target] = src_buf[0:size];
6 #pragma xmp post(p[target], tag)
7 #pragma xmp wait(p[target], tag)
8 }
9 else if(me == 1){
10 #pragma xmp wait(p[target], tag)
11
dst_buf[0:size]:[target] = src_buf[0:size];
12 #pragma xmp post(p[target], tag)
13 }
1 int me;
2 MPI_Comm_rank(..., &me);
3 int target = (me == 0)? 1 : 0;
4 ...
5 if(me == 0){
6
MPI_Isend(src_buf, ..., target, ...);
7
MPI_Wait(...);
8
MPI_Irecv(dst_buf, ..., target, ...);
9
MPI_Wait(...);
10 }
11 else if(me == 1){
12
MPI_Irecv(dst_buf, ..., target, ...);
13
MPI_Wait(...);
14
MPI_Isend(src_buf, ..., target, ...);
15
MPI_Wait(...);
16 }
Fig. 19 Part of the ping-pong benchmark code in XMP and MPI [5]
Latency (micro sec.)
8
64
512
4096
32768
Transfer Size (Byte)
20
16
12
8
4
0
XMP using FJRDMA
MPI_Isend()/Irecv()
Latency (micro sec.)
10
8
6
4
2
0
8
64
512
4096
32768
Transfer Size (Byte)
XMP using GASNet
MPI_Isend()/Irecv()
The K computer
The COMA system
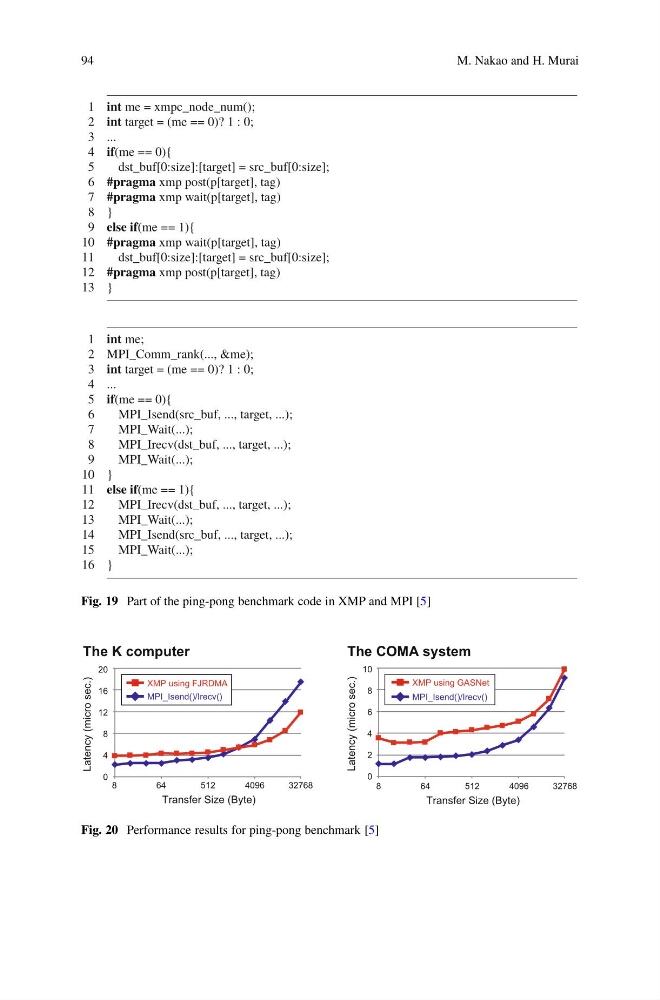
Fig. 20 Performance results for ping-pong benchmark [5]