

while(n
while(n!=0) {
n=n/3;
for(i=n;i
j=i;
while(j>(n-1) && t[j-n]>mem) {
t[j]=t[j-n];
j=j-n;
}
t[j]=mem;
}
for(j=0;j
}
}
}
2. Recherche par dichotomie
La recherche par dichotomie ne s’applique que sur les tableaux déjà triés. Vous avez déjà rencontré un algorithme de
recherche d’élément dans un tableau non trié. Mais celuici posait un problème : si le tableau avait 10000 éléments, et
que par pur hasard celui que vous cherchiez est le 10000
ème , il faudra balayer l’intégralité du tableau. Cette recherche
séquentielle n’est pas idéale.
Dans un tableau trié, la problématique est radicalement différente. Rien qu’avec une recherche séquentielle il devient
inutile de balayer tout le tableau : il suffit de s’arrêter dès que la valeur de l’élément du tableau devient supérieure à ce
qu’on recherche, d’où une probable complexité moyenne plus basse. Mais il reste une solution plus efficace.
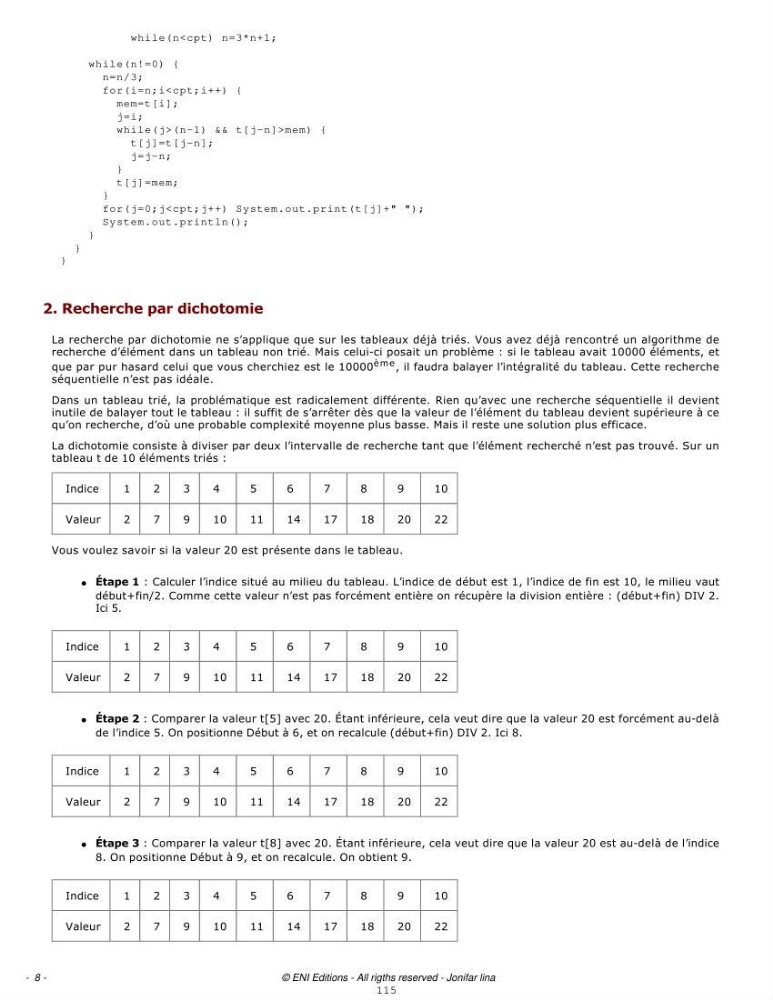
La dichotomie consiste à diviser par deux l’intervalle de recherche tant que l’élément recherché n’est pas trouvé. Sur un
tableau t de 10 éléments triés :
Vous voulez savoir si la valeur 20 est présente dans le tableau.
q Étape 1 : Calculer l’indice situé au milieu du tableau. L’indice de début est 1, l’indice de fin est 10, le milieu vaut
début+fin/2. Comme cette valeur n’est pas forcément entière on récupère la division entière : (début+fin) DIV 2.
Ici 5.
q Étape 2 : Comparer la valeur t[5] avec 20. Étant inférieure, cela veut dire que la valeur 20 est forcément audelà
de l’indice 5. On positionne Début à 6, et on recalcule (début+fin) DIV 2. Ici 8.
q Étape 3 : Comparer la valeur t[8] avec 20. Étant inférieure, cela veut dire que la valeur 20 est audelà de l’indice
8. On positionne Début à 9, et on recalcule. On obtient 9.
Indice
1
2
3
4
5
6
7
8
9
10
Valeur
2
7
9
10
11
14
17
18
20
22
Indice
1
2
3
4
5
6
7
8
9
10
Valeur
2
7
9
10
11
14
17
18
20
22
Indice
1
2
3
4
5
6
7
8
9
10
Valeur
2
7
9
10
11
14
17
18
20
22
Indice
1
2
3
4
5
6
7
8
9
10
Valeur
2
7
9
10
11
14
17
18
20
22
- 8 -
© ENI Editions - All rigths reserved - Jonifar lina
115