

pos←i-1
tant que pos>=0 ET t[pos]>mem Faire
t[pos+1]←t[pos]
pos←pos-1
FinTantQue
t[pos+1]←mem
FinPour
FIN
Comme souvent la complexité varie selon l’ordre initial des éléments dans le tableau à trier. Cependant dans le pire
des cas on effectue (n1) boucles dans lesquelles on effectue une moyenne de (n2)/2 échanges et donc un total de
(n1)(n2)/2. On obtient une complexité d’ordre O(n²). Cependant on effectue en moyenne seulement la moitié des
comparaisons (dans l’exemple cidessus, six comparaisons sont effectuées alors que dix auraient pu être effectuées).
La complexité est alors bien moindre. Dans la pratique un tri par insertion est généralement plus rapide que les tris à
bulles et par sélection.
Une petite remarque concernant le code Java. Si vous faites :
while(t[pos]>mem && pos>=0)
L’expression est évaluée de gauche à droite. Vous allez avoir une erreur à un moment donné : quand pos vaut 0, à la
boucle suivante il vaut 1. Or si un langage comme le C permet de déborder les indices (aucune vérification n’est
effectuée), Java ne le permet pas et cause une exception qui stoppe le programme avec une erreur. Aussi il faut
d’abord tester la valeur de pos AVANT de vérifier le contenu du tableau à cet indice.
while(pos>=0 && t[pos]>mem)
Le code en Java correspondant est le suivant :
class chap5_trinsert {
public static void main(String[] args) {
int t[]={48,17,25,9,34};
int i,j,mem,pos,cpt;
cpt=5;
for(i=1;i
pos=i-1;
while((pos>=0) && (t[pos]>mem)) {
t[pos+1]=t[pos];
pos-;
}
t[pos+1]=mem;
for(j=0;j
System.out.println();
}
}
f. Le tri Shell
Le tri Shell est une variante du tri précédent qui a été proposé par Donald L. Shell en 1959 (il n’y a donc aucun rapport
avec le shell Unix ou Windows). Dans ce type de tri les éléments ne sont plus décalés de un à un mais par pas plus
important. La permutation s’effectue en fonction de ce pas. Une fois les permutations de ce pas effectuées, le pas est
réduit. Quand le pas atteint 1, le tri Shell devient un « bête » tri par insertion. Au final, le tri Shell consiste à dégrossir
un maximum le tableau à trier en plaçant dès les premiers passages le plus d’éléments possibles dans les bonnes
parties du tableau. Dans un tableau d’une dizaine d’éléments, la moyenne des éléments de la première partie du
tableau est plus basse que celle de la deuxième partie, dès le premier passage.
Au final, le tri Shell est d’une complexité O(n 2 ) mais se révèle être plus rapide dans la majorité des cas. C’est
l’algorithme de tri le plus utilisé.
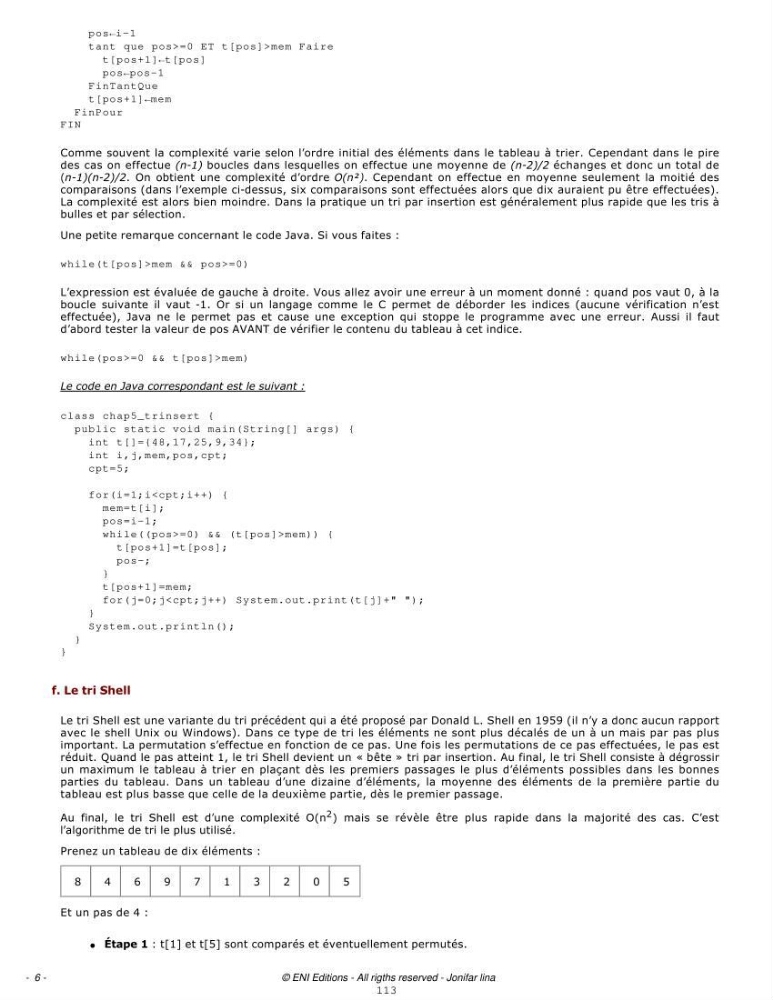
Prenez un tableau de dix éléments :
Et un pas de 4 :
q Étape 1 : t[1] et t[5] sont comparés et éventuellement permutés.
8
4
6
9
7
1
3
2
0
5
- 6 -
© ENI Editions - All rigths reserved - Jonifar lina
113