

186
6 Codes correcteurs
L’hypoth` ese qu’au maximum une lettre est erron´ ee est cruciale. Si deux lettres pouvaient
ˆ etre erron´ ees, alors le r´ ecepteur ne pourrait distinguer, par exemple, entre « w 1 est
erron´ ee » et « w 5 et w 6 sont toutes les deux erron´ ees » et ne pourrait donc effectuer
de correction. Connaissant, le cas ´ ech´ eant, la lettre erron´ ee, il la corrigera, tronquera le
message de ses trois derni` eres lettres, et les quatre lettres restantes seront `
a coup sˆ ur le
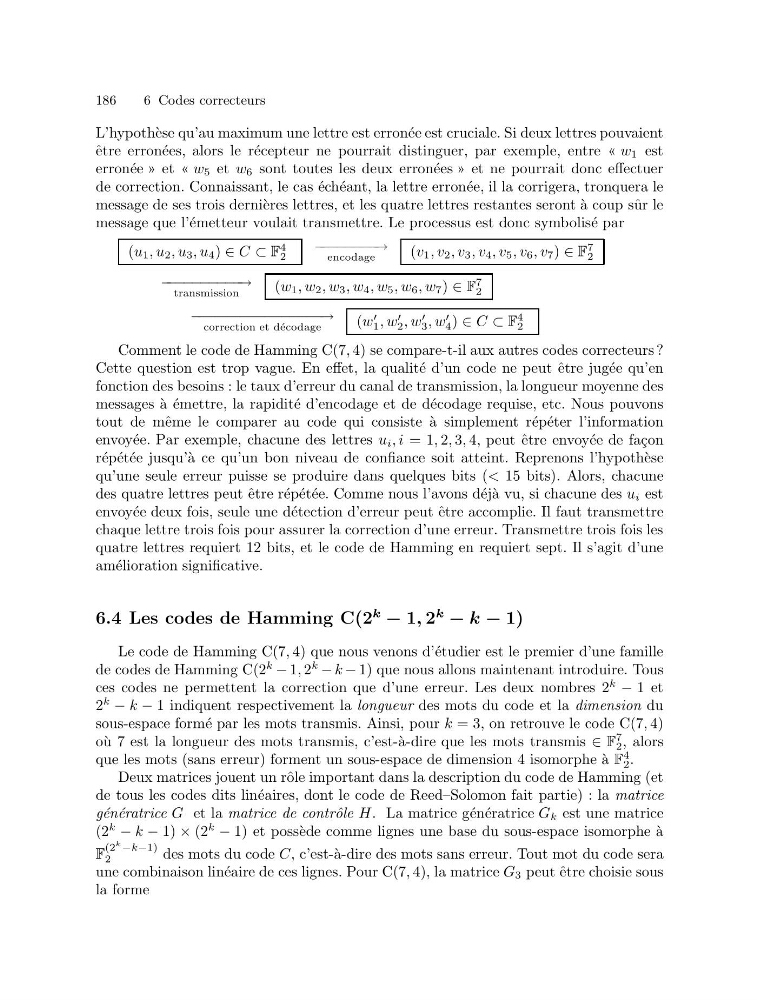
message que l’´ emetteur voulait transmettre. Le processus est donc symbolis´ e par
(u 1 , u 2 , u 3 , u 4 ) ∈ C ⊂ F
4
2
− −−−−−−− →
encodage
(v 1 , v 2 , v 3 , v 4 , v 5 , v 6 , v 7 ) ∈ F
7
2
− −−−−−−−−− →
transmission
(w 1 , w 2 , w 3 , w 4 , w 5 , w 6 , w 7 ) ∈ F
7
2
− −−−−−−−−−−−−−−− →
correction et d´ ecodage
(w
1 , w
2 , w
3 , w
4 ) ∈ C ⊂ F
4
2
Comment le code de Hamming C(7, 4) se compare-t-il aux autres codes correcteurs ?
Cette question est trop vague. En effet, la qualit´ e d’un code ne peut ˆ etre jug´ ee qu’en
fonction des besoins : le taux d’erreur du canal de transmission, la longueur moyenne des
messages ` a ´ emettre, la rapidit´ e d’encodage et de d´ ecodage requise, etc. Nous pouvons
tout de mˆ eme le comparer au code qui consiste ` a simplement r´ ep´ eter l’information
envoy´ ee. Par exemple, chacune des lettres u i , i = 1, 2, 3, 4, peut ˆ etre envoy´ ee de fa¸ con
r´ ep´ et´ ee jusqu’` a ce qu’un bon niveau de confiance soit atteint. Reprenons l’hypoth` ese
qu’une seule erreur puisse se produire dans quelques bits (< 15 bits). Alors, chacune
des quatre lettres peut ˆ etre r´ ep´ et´ ee. Comme nous l’avons d´ ej` a vu, si chacune des u i est
envoy´ ee deux fois, seule une d´ etection d’erreur peut ˆ etre accomplie. Il faut transmettre
chaque lettre trois fois pour assurer la correction d’une erreur. Transmettre trois fois les
quatre lettres requiert 12 bits, et le code de Hamming en requiert sept. Il s’agit d’une
am´ elioration significative.
6.4 Les codes de Hamming C(2
k
− 1, 2
k
− k − 1)
Le code de Hamming C(7, 4) que nous venons d’´ etudier est le premier d’une famille
de codes de Hamming C(2
k
− 1, 2
k
− k − 1) que nous allons maintenant introduire. Tous
ces codes ne permettent la correction que d’une erreur. Les deux nombres 2
k
− 1 et
2
k
− k − 1 indiquent respectivement la longueur des mots du code et la dimension du
sous-espace form´ e par les mots transmis. Ainsi, pour k = 3, on retrouve le code C(7, 4)
o` u 7 est la longueur des mots transmis, c’est-` a-dire que les mots transmis ∈ F
7
2 , alors
que les mots (sans erreur) forment un sous-espace de dimension 4 isomorphe ` a F
4
2 .
Deux matrices jouent un rˆ ole important dans la description du code de Hamming (et
de tous les codes dits lin´ eaires, dont le code de Reed–Solomon fait partie) : la matrice
g´ en´ eratrice G et la matrice de contrˆ ole H. La matrice g´ en´ eratrice G k est une matrice
(2
k
− k − 1) × (2
k
− 1) et poss` ede comme lignes une base du sous-espace isomorphe ` a
F
(2
k −k−1)
2
des mots du code C, c’est-` a-dire des mots sans erreur. Tout mot du code sera
une combinaison lin´ eaire de ces lignes. Pour C(7, 4), la matrice G 3 peut ˆ etre choisie sous
la forme