

168
5 Systèmes linéaires
0
5
10
15
20
25
30
35
40
10
−14
10
−12
10
−10
10
−8
10
−6
10
−4
10
−2
10
0
Jacobi
Gauss−Seidel
Gradient
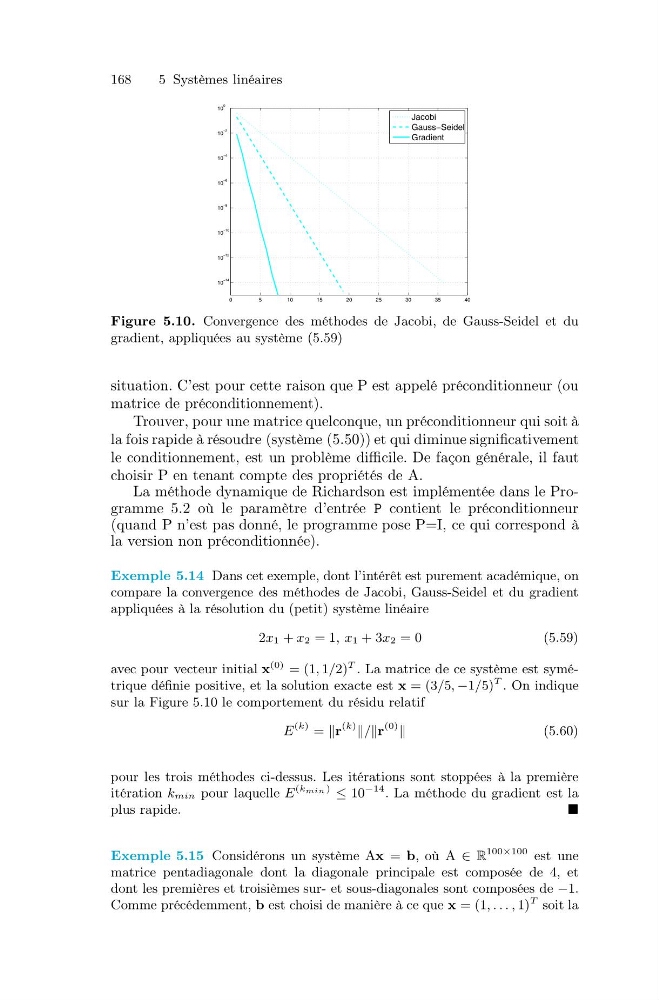
Figure 5.10. Convergence des méthodes de Jacobi, de Gauss-Seidel et du
gradient, appliquées au système (5.59)
situation. C’est pour cette raison que P est appelé préconditionneur (ou
matrice de préconditionnement).
Trouver, pour une matrice quelconque, un préconditionneur qui soit à
la fois rapide à résoudre (système (5.50)) et qui diminue significativement
le conditionnement, est un problème difficile. De façon générale, il faut
choisir P en tenant compte des propriétés de A.
La méthode dynamique de Richardson est implémentée dans le Programme 5.2 où le paramètre d’entrée P contient le préconditionneur
(quand P n’est pas donné, le programme pose P=I, ce qui correspond à
la version non préconditionnée).
Exemple 5.14 Dans cet exemple, dont l’intérêt est purement académique, on
compare la convergence des méthodes de Jacobi, Gauss-Seidel et du gradient
appliquées à la résolution du (petit) système linéaire
2x1 + x2 = 1, x1 + 3x2 = 0
(5.59)
avec pour vecteur initial x
(0) = (1, 1/2)
T . La matrice de ce système est symétrique définie positive, et la solution exacte est x = (3/5, −1/5)
T . On indique
sur la Figure 5.10 le comportement du résidu relatif
E
(k) = r
(k) /r
(0)
(5.60)
pour les trois méthodes ci-dessus. Les itérations sont stoppées à la première
itération kmin pour laquelle E
(k min ) ≤ 10
−14 . La méthode du gradient est la
plus rapide.
Exemple 5.15 Considérons un système Ax = b, où A ∈ R
100×100 est une
matrice pentadiagonale dont la diagonale principale est composée de 4, et
dont les premières et troisièmes sur- et sous-diagonales sont composées de −1.
Comme précédemment, b est choisi de manière à ce que x = (1, . . . , 1)
T soit la