

290
Statistique appliquée aux sciences de la vie
●
●●●
●
● ● ● ●●● ● ● ● ●
●
● ●● ●● ●
●
● ●● ●●
●
●●
●
●● ●●
●
●
●
● ●● ● ●
●
● ●
●
● ●
● ●
●
●
●
●
● ●
●
●
● ●
● ●
●
●
●
●●
●● ●●
●
● ●● ● ●
● ●
● ● ● ●
●
● ●● ●
●
●●● ●●
●
●●
●
20
30
40
50
60
70
0.0
0.2
0.4
0.6
0.8
1.0
âge (années)
maladie (0/1)
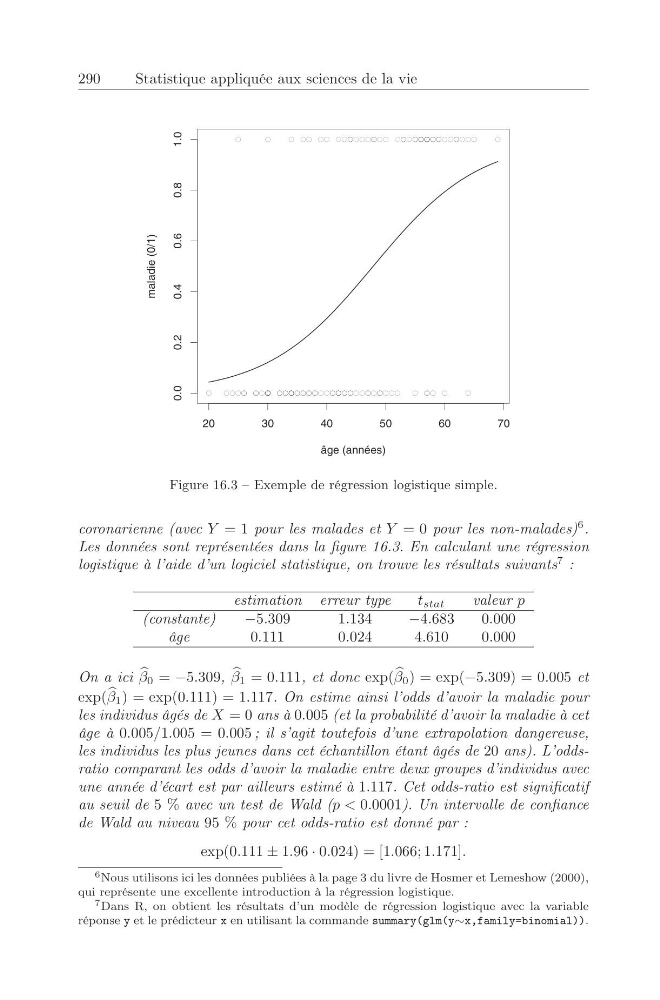
Figure 16.3 – Exemple de régression logistique simple.
coronarienne (avec Y = 1 pour les malades et Y = 0 pour les non-malades)
6 .
Les données sont représentées dans la figure 16.3. En calculant une régression
logistique à l’aide d’un logiciel statistique, on trouve les résultats suivants
7 :
estimation erreur type
t stat
valeur p
(constante)
−5.309
1.134
−4.683
0.000
âge
0.111
0.024
4.610
0.000
On a ici
β 0 = −5.309,
β 1 = 0.111, et donc exp(
β 0 ) = exp(−5.309) = 0.005 et
exp(
β 1 ) = exp(0.111) = 1.117. On estime ainsi l’odds d’avoir la maladie pour
les individus âgés de X = 0 ans à 0.005 (et la probabilité d’avoir la maladie à cet
âge à 0.005/1.005 = 0.005 ; il s’agit toutefois d’une extrapolation dangereuse,
les individus les plus jeunes dans cet échantillon étant âgés de 20 ans). L’oddsratio comparant les odds d’avoir la maladie entre deux groupes d’individus avec
une année d’écart est par ailleurs estimé à 1.117. Cet odds-ratio est significatif
au seuil de 5 % avec un test de Wald (p < 0.0001). Un intervalle de confiance
de Wald au niveau 95 % pour cet odds-ratio est donné par :
exp(0.111 ± 1.96 · 0.024) = [1.066; 1.171].
6 Nous utilisons ici les données publiées à la page 3 du livre de Hosmer et Lemeshow (2000),
qui représente une excellente introduction à la régression logistique.
7 Dans R, on obtient les résultats d’un modèle de régression logistique avec la variable
réponse y et le prédicteur x en utilisant la commande summary(glm(y∼x,family=binomial)).