

244
Statistique appliquée aux sciences de la vie
Afin d’essayer de rejeter cette hypothèse nulle, on utilise la statistique de
test suivante :
T stat =
n − m − 1
m
·
ρ
2
1 −
ρ 2 .
Il se trouve que l’on connaît mathématiquement la distribution de T stat sous
H 0 (et sous les hypothèses d’un modèle de régression linéaire). Il s’agit en effet
d’une distribution de Fisher (ou distribution F ) avec paramètres dln = m et
dld = n − m − 1
20 . On rejette ainsi l’hypothèse nulle au seuil α si on a :
t stat ≥ F 1−α,m,n−m−1
où F 1−α,m,n−m−1 dénote le quantile 1−α d’une distribution F avec paramètres
dln = m et dld = n − m − 1. Le tableau A.4 donné en annexe nous en donne
quelques-uns (avec α = 0.05). Il s’agit d’un test exact sous les hypothèses du
modèle. Dans le cas du rejet de l’hypothèse nulle, on conclut qu’au moins une
pente est non nulle (sans que l’on sache ni laquelle, ni le signe de cette pente)
et donc que ρ
2 > 0. Dans le cas m = 1, ce test F est équivalent à un test
de Student bilatéral sur la nullité de l’unique pente d’un modèle de régression
simple
21 .
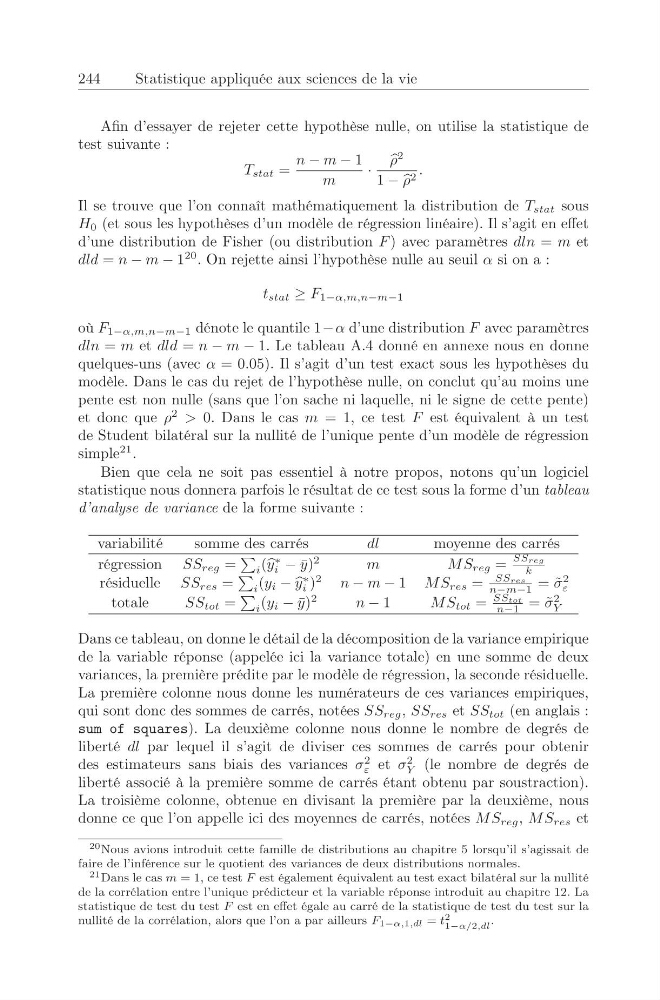
Bien que cela ne soit pas essentiel à notre propos, notons qu’un logiciel
statistique nous donnera parfois le résultat de ce test sous la forme d’un tableau
d’analyse de variance de la forme suivante :
variabilité
somme des carrés
dl
moyenne des carrés
régression SS reg =
i ( y
∗
i − ¯
y)
2
m
M S reg =
SSreg
k
résiduelle SS res =
i (y i −
y
∗
i )
2
n − m − 1 MS res =
SSres
n−m−1 = ˜
σ
2
ε
totale
SS tot =
i (y i − ¯
y)
2
n − 1
MS tot =
SStot
n−1 = ˜
σ
2
Y
Dans ce tableau, on donne le détail de la décomposition de la variance empirique
de la variable réponse (appelée ici la variance totale) en une somme de deux
variances, la première prédite par le modèle de régression, la seconde résiduelle.
La première colonne nous donne les numérateurs de ces variances empiriques,
qui sont donc des sommes de carrés, notées SS reg , SS res et SS tot (en anglais :
sum of squares). La deuxième colonne nous donne le nombre de degrés de
liberté dl par lequel il s’agit de diviser ces sommes de carrés pour obtenir
des estimateurs sans biais des variances σ
2
ε et σ
2
Y (le nombre de degrés de
liberté associé à la première somme de carrés étant obtenu par soustraction).
La troisième colonne, obtenue en divisant la première par la deuxième, nous
donne ce que l’on appelle ici des moyennes de carrés, notées MS reg , MS res et
20 Nous avions introduit cette famille de distributions au chapitre 5 lorsqu’il s’agissait de
faire de l’inférence sur le quotient des variances de deux distributions normales.
21 Dans le cas m = 1, ce test F est également équivalent au test exact bilatéral sur la nullité
de la corrélation entre l’unique prédicteur et la variable réponse introduit au chapitre 12. La
statistique de test du test F est en effet égale au carré de la statistique de test du test sur la
nullité de la corrélation, alors que l’on a par ailleurs F 1−α,1,dl = t 2
1−α/2,dl
.