

13. Régression linéaire simple
207
des estimateurs sans biais et normalement distribués des véritables paramètres
β 0 et β 1 . Il s’ensuit que
β 0 +
β 1 x est un estimateur sans biais et normalement
distribué de β 0 + β 1 x (la véritable moyenne de Y dans le groupe X = x). Pour
β 0 et
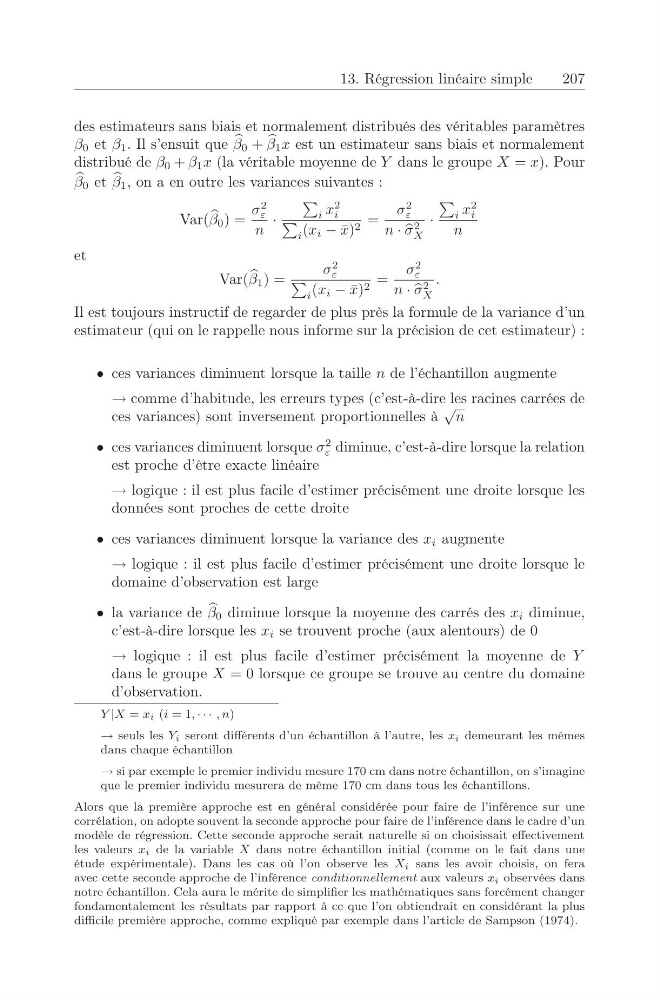
β 1 , on a en outre les variances suivantes :
Var(
β 0 ) =
σ
2
ε
n
·
i x
2
i
i (x i − ¯
x) 2 =
σ
2
ε
n ·
σ 2
X
·
i x
2
i
n
et
Var(
β 1 ) =
σ
2
ε
i (x i − ¯
x) 2 =
σ
2
ε
n ·
σ 2
X
.
Il est toujours instructif de regarder de plus près la formule de la variance d’un
estimateur (qui on le rappelle nous informe sur la précision de cet estimateur) :
• ces variances diminuent lorsque la taille n de l’échantillon augmente
→ comme d’habitude, les erreurs types (c’est-à-dire les racines carrées de
ces variances) sont inversement proportionnelles à
√
n
• ces variances diminuent lorsque σ
2
ε diminue, c’est-à-dire lorsque la relation
est proche d’être exacte linéaire
→ logique : il est plus facile d’estimer précisément une droite lorsque les
données sont proches de cette droite
• ces variances diminuent lorsque la variance des x i augmente
→ logique : il est plus facile d’estimer précisément une droite lorsque le
domaine d’observation est large
• la variance de
β 0 diminue lorsque la moyenne des carrés des x i diminue,
c’est-à-dire lorsque les x i se trouvent proche (aux alentours) de 0
→ logique : il est plus facile d’estimer précisément la moyenne de Y
dans le groupe X = 0 lorsque ce groupe se trouve au centre du domaine
d’observation.
Y |X = x i (i = 1, · · · , n)
→ seuls les Y i seront différents d’un échantillon à l’autre, les x i demeurant les mêmes
dans chaque échantillon
→ si par exemple le premier individu mesure 170 cm dans notre échantillon, on s’imagine
que le premier individu mesurera de même 170 cm dans tous les échantillons.
Alors que la première approche est en général considérée pour faire de l’inférence sur une
corrélation, on adopte souvent la seconde approche pour faire de l’inférence dans le cadre d’un
modèle de régression. Cette seconde approche serait naturelle si on choisissait effectivement
les valeurs x i de la variable X dans notre échantillon initial (comme on le fait dans une
étude expérimentale). Dans les cas où l’on observe les X i sans les avoir choisis, on fera
avec cette seconde approche de l’inférence conditionnellement aux valeurs x i observées dans
notre échantillon. Cela aura le mérite de simplifier les mathématiques sans forcément changer
fondamentalement les résultats par rapport à ce que l’on obtiendrait en considérant la plus
difficile première approche, comme expliqué par exemple dans l’article de Sampson (1974).