

Chapitre VI
Machine Learning
103
VI.7. Modèle développé pour les digues à talus
La base de données nettoyée contenant 8091 essais avec différents types de structures a été réduite
en adaptant que les structures les plus similaires aux digues à talus implantés au niveau de la
Marina et du Port d’Alger. De plus, les données ont été filtrées en fonction de leur facteur de
fiabilité, les essais avec une fiabilité de niveau 1, 2 et 3 ont été choisis.
Afin d'améliorer les performances des prédictions des franchissements des vagues pour obtenir un
bon score, on a éliminé les caractéristiques ayant le moins d'influence. Les paramètres
hydrauliques des eaux profondes n'ont pas été pris en compte pour éviter la redondance, car ils
sont fortement liés aux paramètres au pied de l'ouvrage. En revanche, les tests correspondant à des
franchissements avec í µí± = 0 í µí±
3 /s/m ont été pris en compte. La base de données résultante
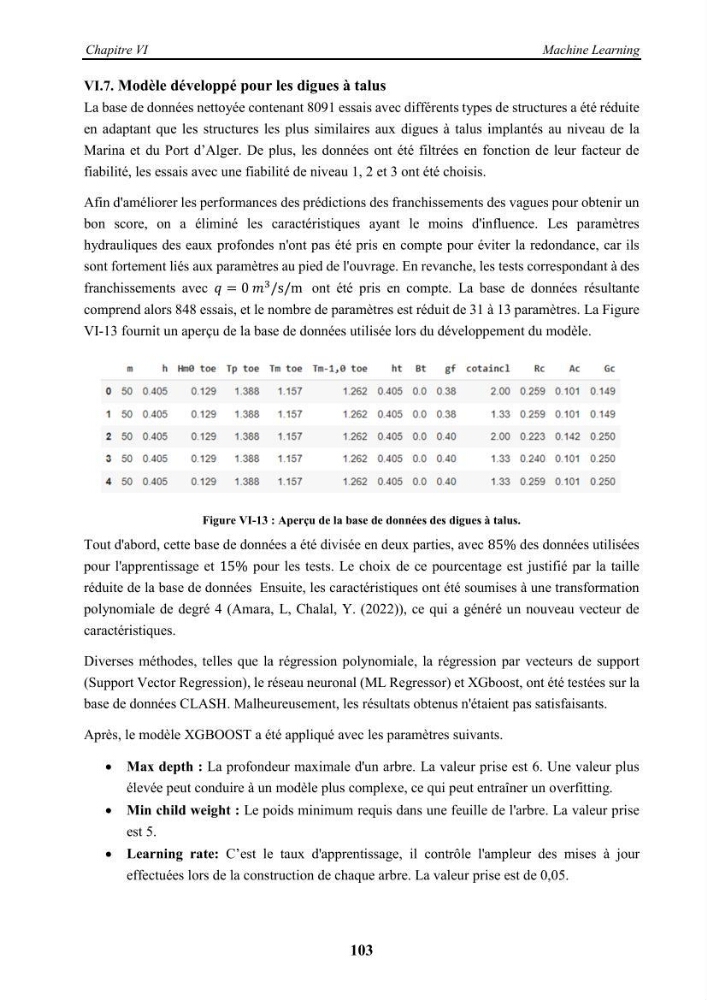
comprend alors 848 essais, et le nombre de paramètres est réduit de 31 à 13 paramètres. La Figure
VI-13 fournit un aperçu de la base de données utilisée lors du développement du modèle.
Figure VI-13 : Aperçu de la base de données des digues à talus.
Tout d'abord, cette base de données a été divisée en deux parties, avec 85% des données utilisées
pour l'apprentissage et 15% pour les tests. Le choix de ce pourcentage est justifié par la taille
réduite de la base de données Ensuite, les caractéristiques ont été soumises à une transformation
polynomiale de degré 4 (Amara, L, Chalal, Y. (2022)), ce qui a généré un nouveau vecteur de
caractéristiques.
Diverses méthodes, telles que la régression polynomiale, la régression par vecteurs de support
(Support Vector Regression), le réseau neuronal (ML Regressor) et XGboost, ont été testées sur la
base de données CLASH. Malheureusement, les résultats obtenus n'étaient pas satisfaisants.
Après, le modèle XGBOOST a été appliqué avec les paramètres suivants.
Max depth : La profondeur maximale d'un arbre. La valeur prise est 6. Une valeur plus
élevée peut conduire à un modèle plus complexe, ce qui peut entraîner un overfitting.
Min child weight : Le poids minimum requis dans une feuille de l'arbre. La valeur prise
est 5.
Learning rate: C’est le taux d'apprentissage, il contrôle l'ampleur des mises à jour
effectuées lors de la construction de chaque arbre. La valeur prise est de 0,05.