

Chapitre II
Matériel et méthodes
24
í µí°¸ í µí± = √
1
í µí±
∑ í µí»½ í µí± (
í µí± í µí± − í µí± ̂ í µí±
í µí± í µí±
) ²
í µí±
í µí±=1
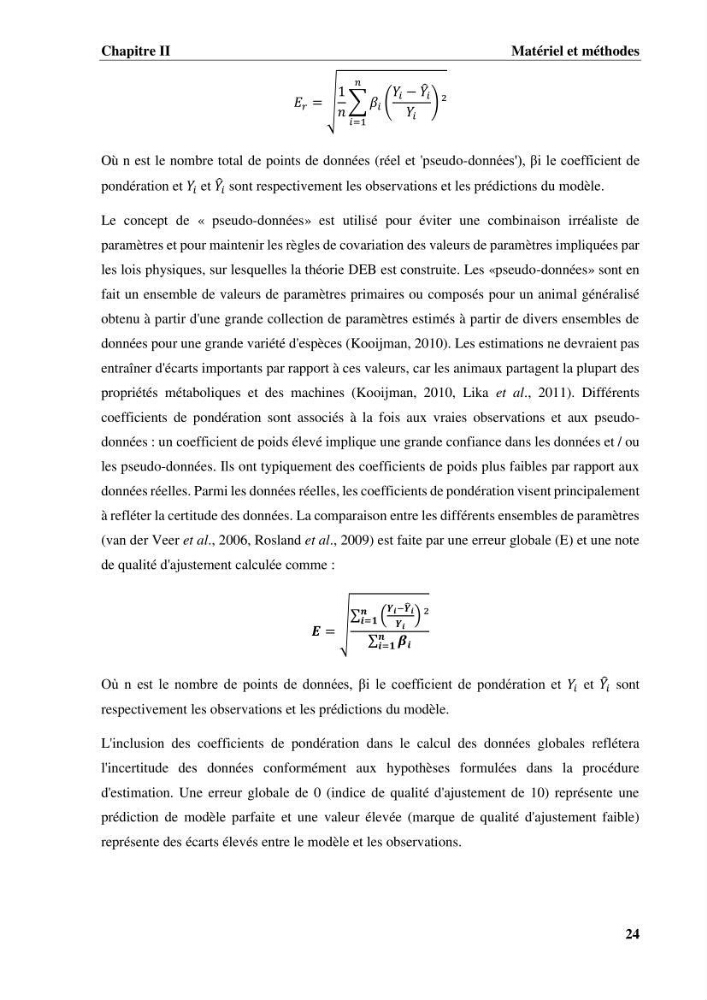
Où n est le nombre total de points de données (réel et 'pseudo-données'), βi le coefficient de
pondération et í µí± í µí± et í µí± ̂ í µí± sont respectivement les observations et les prédictions du modèle.
Le concept de « pseudo-données» est utilisé pour éviter une combinaison irréaliste de
paramètres et pour maintenir les règles de covariation des valeurs de paramètres impliquées par
les lois physiques, sur lesquelles la théorie DEB est construite. Les «pseudo-données» sont en
fait un ensemble de valeurs de paramètres primaires ou composés pour un animal généralisé
obtenu à partir d'une grande collection de paramètres estimés à partir de divers ensembles de
données pour une grande variété d'espèces (Kooijman, 2010). Les estimations ne devraient pas
entraîner d'écarts importants par rapport à ces valeurs, car les animaux partagent la plupart des
propriétés métaboliques et des machines (Kooijman, 2010, Lika et al., 2011). Différents
coefficients de pondération sont associés à la fois aux vraies observations et aux pseudodonnées : un coefficient de poids élevé implique une grande confiance dans les données et / ou
les pseudo-données. Ils ont typiquement des coefficients de poids plus faibles par rapport aux
données réelles. Parmi les données réelles, les coefficients de pondération visent principalement
à refléter la certitude des données. La comparaison entre les différents ensembles de paramètres
(van der Veer et al., 2006, Rosland et al., 2009) est faite par une erreur globale (E) et une note
de qualité d'ajustement calculée comme :
í µí±¬ = √
∑ (
í µí² í µí² −í µí² ̂ í µí²
í µí² í µí²
) ²
í µí²
í µí²=í µí¿
∑ í µí¼· í µí²
í µí²
í µí²=í µí¿
Où n est le nombre de points de données, βi le coefficient de pondération et í µí± í µí± et í µí± ̂ í µí± sont
respectivement les observations et les prédictions du modèle.
L'inclusion des coefficients de pondération dans le calcul des données globales reflétera
l'incertitude des données conformément aux hypothèses formulées dans la procédure
d'estimation. Une erreur globale de 0 (indice de qualité d'ajustement de 10) représente une
prédiction de modèle parfaite et une valeur élevée (marque de qualité d'ajustement faible)
représente des écarts élevés entre le modèle et les observations.